DriftWorld: Fast World Modeling through Drifting
DriftWorld: Fast World Modeling through Drifting
一句话总结
DriftWorld 将动作条件世界模型中的多步扩散生成机制改为基于漂移生成模型的单步生成方式。它在训练时学习一个动作条件漂移场,使模型在推理时只需一次前向传播即可根据当前观测和候选动作生成未来帧。这种方法显著提高了 rollout 速度,平均比扩散世界模型快约 17 倍,因此更适合推理时的大规模动作搜索和离线策略评估。
摘要与引言
提出 DriftWorld,一个基于漂移生成模型的动作条件世界模型。不在推理时进行迭代去噪,而是在训练阶段学习一个动作条件漂移场,因此能够仅通过一次前向传播,就根据当前观测和候选动作序列生成未来帧,速度超过 30 fps,平均比基于扩散模型的基线快 17 倍。
这些世界模型的实际价值受到推理速度的瓶颈限制。当前最先进的模型大多基于扩散模型,因此需要迭代式多步去噪来生成未来帧。这种多步采样对实时规划来说太慢。
提出 DriftWorld,一个基于漂移生成模型的快速动作条件世界模型。与基于扩散的模型不同,DriftWorld 能够在单次前向传播中生成高质量的未来帧。它通过在训练阶段学习一个将先验噪声分布映射到数据分布的漂移场来实现单步生成。因此,推理时不再需要扩散模型所使用的迭代式多步采样。
原始漂移模型是为类条件图像生成设计的。将其改造为动作条件视频生成模型,需要重新思考三个组件:
- 由初始观测和动作序列定义的条件漂移场,并进行修改以强化模型对动作的跟随;
- 利用 DINOv2/v3 的漂移特征空间,以在复杂场景中保持视觉清晰度;
- 一种 U-Net 架构,确保每个视频帧都精确地以对应动作为条件。
主要贡献如下:
- DriftWorld: 我们提出一个单步动作条件世界模型,每次 rollout 只需一次前向传播,平均比基于扩散的世界模型快 17 倍。
- 面向机器人模拟的漂移模型定制: 我们首次将漂移生成模型改造用于条件视频预测,提出动作强化漂移场、特征空间漂移损失以及逐帧动作条件化。
- 实验验证: 我们证明 DriftWorld 在五个基准上以显著更快的速度达到或超过基线的 rollout 质量,使推理时的动作搜索和离线策略评估都更加高效。
方法
本节提出 DriftWorld,一个基于漂移机制的动作条件世界模型。它可以通过一次前向传播生成高质量的未来帧预测。这种单步生成方式使 DriftWorld 在生成 rollout 时显著快于现有动作条件世界模型,而现有模型主要依赖多步扩散。
问题形式化
提出首个基于近期漂移生成模型构建的动作条件世界模型。借助漂移机制,我们的模型可以在单次前向传播中生成未来帧,这是效率上的显著提升。
为了将漂移机制应用于视频生成,我们将该过程形式化为如下形式。令 表示漂移世界模型,它将噪声先验 和条件信息 映射到生成的未来视频帧:
其中条件信息 由历史帧 和未来动作 组成。根据提供的动作数量,模型可以进行单步模拟或 chunk 级模拟。为简化表示,下文省略条件 。 生成视频帧的分布是前推分布:
与依赖推理时迭代多步优化的扩散模型不同,漂移生成模型在训练时优化生成分布 ,使其逐渐演化到真实数据分布 。我们定义一个漂移场 ,决定样本应如何移动才能使 演化到 。给定来自模型当前前推分布 的生成视频块 ,漂移后的新视频块定义为:
漂移向量 会把 吸向真实分布 中的正样本视频块,并把它推离生成分布 中的负样本视频块:
其中 和 分别是正样本视频块和负样本视频块的均值漂移向量。标准的类条件图像生成漂移模型通常使用多个正样本;但 DriftWorld 只使用一个正样本,因为给定当前帧和待执行动作后,未来帧序列是唯一的。因此:
- 正样本 是从数据集中抽取的唯一的真实未来观测块 。
- 负样本 是由模型生成的 个未来观测块 。
关键在于,当生成分布 与真实条件视频分布 匹配时,系统达到平衡。此时漂移场变为 0,样本不再移动。
从扩散模型到漂移模型
扩散模型的思路是:
- 把真实数据逐步加噪;
- 训练模型学习如何从噪声中逐步还原数据;
- 推理时从噪声开始,反复调用模型去噪几十、几百步,最终得到样本。 所以扩散模型质量高,但推理慢。
漂移模型换了一种思路:
- 直接训练一个生成器 ,让它把高斯噪声映射成数据;
- 训练过程中不断调整生成器,使它的输出分布更接近真实数据分布;
- 训练完成后,推理时只需一次前向传播。
前推分布
其中:
- 是高斯噪声;
- 是条件信息,包括历史帧和未来动作;
- 是漂移世界模型;
- 是生成的未来视频帧。
由于 有一个概率分布 ,经过 映射后,生成结果也会形成一个分布。这个分布记作:
这个符号叫“前推分布”。直观理解就是: 给噪声分布中的每个样本套上生成器 ,得到的所有生成结果组成的分布,就是 。
漂移模型的目标是让这个生成分布 逐渐靠近真实数据分布 。
DriftWorld 的训练流程
训练目标与伪代码
模型 通过不动点迭代优化:
该损失函数将模型预测推向一个由漂移场偏移后的冻结目标
算法1
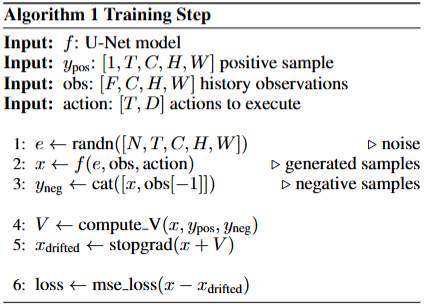 算法 1 给出了对数据集中一个视频应用单次训练步骤的伪代码。当在一个包含 B 个视频的批次上进行训练时,我们会针对每个视频独立地执行该步骤。由于每个视频都包含一段唯一的历史观测与动作序列,模型必须计算 B 个不同且独立的条件漂移场。在这 B 个场中的每一个内,漂移都是使用一个正样本(真实未来帧)和 个负样本(模型生成的未来帧)来计算的。总损失是该批次中 B 个单独损失之和。
- 输入:,U-Net 模型
- 输入:,形状为 的正样本
- 输入:,形状为 的历史观测
- 输入:,形状为 的待执行动作
- ,生成噪声;
- ,生成样本;
- ,构造负样本;
- 计算 ;
- ;
- 计算损失 。
强化动作跟随
为提高模型对动作条件的服从性,我们可以在训练时可选地修改目标分布。
给定动作 和历史帧 ,正样本从真实分布 中抽取;而负样本则从以下两类样本的混合中抽取:(1) 模型生成样本;(2) 描述未执行动作状态的真实样本,即真实帧 。负样本分布变为:
其中 。两项分别是生成样本分布和真实的无动作分布。
- 是模型在给定动作后生成的未来帧分布;
- 表示“没有动作”或“不执行动作”时的真实未来帧分布。直观上就是当前状态保持不变、机械臂不动的画面;
- 控制这种“无动作真实帧”在负样本中的比例。
漂移空间
计算漂移损失的空间可以根据数据集复杂度调整。对于较简单的数据集,可以直接在模型原始输出空间中计算损失,例如像素空间。
对于 Bridge-V2 和 RT-1 这类复杂数据集,我们使用编码器 将输出投影到特征空间,并在这些特征上施加损失,使 漂移向 ,同时远离 。由于用于计算漂移均值漂移向量的核函数依赖成对样本相似度,在特征空间中操作能获得更语义化的距离度量。
使用 DINOv2/v3 特征编码器。对于一个 的特征图,我们在每个 空间位置分别建立独立的漂移场;每个漂移场作用于该位置上的 维向量。最终损失是 个独立漂移损失的加权平均,其中权重可以全部相等,也可以由该位置的运动幅度决定。
基于运动加权
为了惩罚模型忽略动作条件,我们对运动更大的空间位置赋予更高的漂移损失权重。运动量被量化为目标未来帧 的特征与前一帧 的特征之间的 L2 距离,权重则是该空间位置运动量的双曲正切函数。
动作条件架构
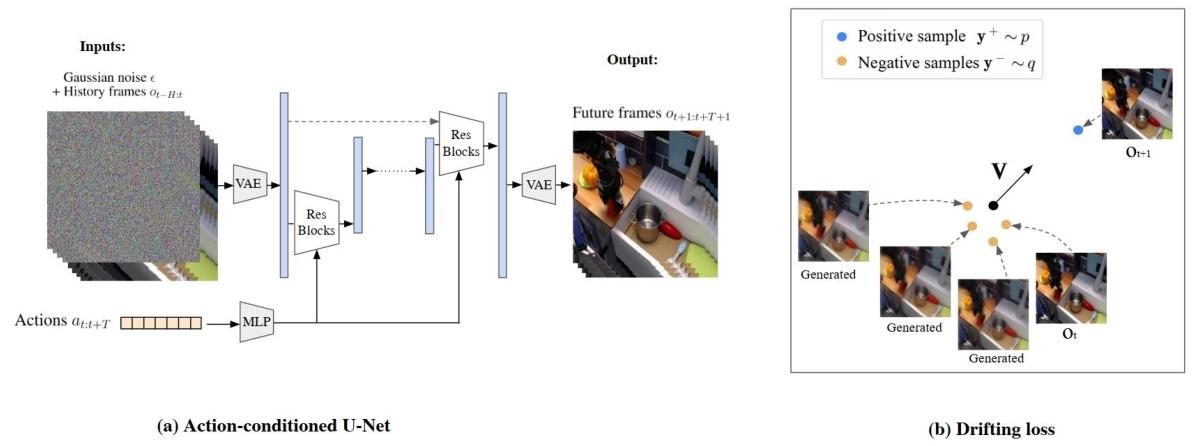 图2:漂移架构与训练概览。(a) 我们使用一个以历史观测和机器人动作为条件的 U-Net 架构。(b) DriftWorld 使用漂移损失进行训练,该损失是一种对比损失,促使生成的未来帧(负样本)向真实未来帧(正样本)漂移。
DriftWorld 的核心生成器采用动作条件 U-Net 架构(图 2a)。U-Net 的输入包括当前帧和历史帧 、待执行动作 ,以及可选的语言指令。它输出预测的未来帧 。
为了一次性生成多个未来帧,U-Net 使用文献中的因子化时空卷积:先对每个 个时间步独立且相同地施加空间卷积,再在每个空间位置独立且相同地施加时间卷积。
U-Net 使用 FiLM,并可选地使用交叉注意力,将动作 逐帧注入模型,从而确保每个动作 对应地条件化由该动作产生的未来帧 。模型还通过将历史帧与初始高斯噪声在通道维度拼接,实现对历史帧的条件化。
推理流程与策略模拟
在推理时,DriftWorld 使用单次前向传播生成未来视频帧:
其中 是高斯噪声。
这使得 DriftWorld 能够高效执行下游策略模拟
实验
实验设置
数据集
- Bridge-V2:真实世界数据集,60,096 条轨迹,24 个环境;主相机分辨率调整为 256 × 256。
- RT-1:真实世界数据集,87,212 条轨迹,3 个环境;主相机分辨率调整为 256 × 256。
- Language Table:真实世界桌面操作数据集,442,226 条轨迹;相机分辨率调整为 192 × 256。
- Push-T:仿真任务,共 500 条专家演示和随机探索轨迹;分辨率 96 × 96。
- Robomimic:包括 Lift、Can、Square 任务,每个任务 700 条轨迹,包含成功和失败案例;分辨率 96 × 96。
DriftWorld 配置
- 输入:当前帧、3 帧历史帧、T 个未来动作。
- 输出:T 个未来帧。
- 预测时域 T:
- Push-T:4
- Robomimic:2
- Bridge-V2:1
- RT-1:1
- Language Table:1
- 简单环境:直接在像素空间计算漂移损失。
- 复杂真实世界环境:U-Net 在 Stable Diffusion 3 VAE 的 latent 空间中生成,漂移损失在 DINOv2/v3 特征空间中计算。
基线模型 主要比较:
- IRASim
- WorldGym
- Ctrl-World
- GPC diffusion world model
- VDM
- LVDM
- AVDC
- MSE baseline
其中 MSE baseline 与 DriftWorld 使用相同 U-Net backbone,但用普通 MSE 损失训练,用来验证漂移损失本身的有效性。
评价指标 视觉质量:
- MSE
- SSIM
- PSNR
- LPIPS
- FID
- FVD
效率:
- 每帧生成时间
下游策略任务:
- Push-T IoU
- Robomimic 成功率
- 预测性能与真实性能的相关性
实验设计
论文围绕四个问题设计实验:
- 视觉建模质量与速度 DriftWorld 生成的视频是否在质量上达到或超过扩散世界模型,同时显著更快?
- 推理时策略改进 在世界模型中 rollout 多个候选动作,再选择高奖励动作,是否能提升真实执行性能?
- 离线策略评估 DriftWorld 是否能作为离线模拟器,准确预测真实策略的绝对性能和相对排名?
- 核心组件消融 DINOv2/v3 特征空间、运动加权、self-forcing 对最终性能是否必要?
实验效果
视觉生成质量
Push-T
- DriftWorld 在 64 帧和整段 rollout 上都优于大部分基线。
- 相比扩散世界模型,速度快 3.2× 到 478×。
- 64 帧 rollout 上,DriftWorld 的 MSE 为 0.0020,SSIM 为 0.9941,PSNR 为 34.7751。
- 每帧生成时间约为 0.0037 s,而 GPC world model 约为 0.0104 s,Ctrl-World 约为 1.7714 s。
- DriftWorld 优于同样单步生成但使用 MSE 损失的 baseline,说明性能提升不仅来自单步生成,也来自漂移损失。
Robomimic
- 在单视角和双视角设置下,DriftWorld 都与 Ctrl-World 和 GPC 具有竞争力。
- 同时推理时间显著更短。
- 例如 Lift 单视角任务中,DriftWorld 每帧时间约 0.0100 s,GPC 约为 0.0331 s。
Bridge-V2 / RT-1 / Language Table
- DriftWorld 在大多数视觉质量指标上超过基线。
- 真实世界场景中,DriftWorld 能更准确地模拟机器人夹爪与物体的接触和运动。
- 相比 IRASim,DriftWorld 的动作跟随能力更强。
- 生成速度远高于现有动作条件世界模型。
推理时策略改进
论文使用 GPC-RANK 方法:
- 基础策略每次采样 K = 50 个候选动作块。
- 每个候选动作块在 DriftWorld 中 rollout。
- 用 reward model 对预测未来观测打分。
- 选择得分最高的动作块在真实环境中执行。
| 方法 | Policy 1 IoU | Policy 2 IoU | 时间 |
|---|---|---|---|
| 无 GPC-RANK | 0.635 | 0.612 | - |
| GPC world model | 0.698 | 0.614 | 2.241 s |
| AVDC | 0.726 | 0.682 | 106.1 s |
| MSE baseline | 0.639 | 0.609 | 0.912 s |
| DriftWorld | 0.772 | 0.755 | 0.912 s |
结论:
- DriftWorld 能显著提升两个基础策略的 IoU。
- 性能优于 GPC、AVDC 和 MSE baseline。
- rollout 全部候选动作的时间远低于扩散世界模型和 AVDC。
离线策略评估
Push-T
- 评估 7 个 diffusion policies。
- 比较 DriftWorld 中预测的 IoU 与真实 Push-T 模拟器中的 IoU。
- 每个 policy 使用 100 个初始化 seed。
- DriftWorld 只在 policy 5 和 6 之间出现一次排名颠倒。
- 预测与真实 IoU 的相关性为 0.9515。
- GPC baseline 的相关性只有 0.7345。
Robomimic
- 评估 9 个 diffusion policies。
- 每个 rollout 使用 50 个环境初始化 seed。
- 为了覆盖失败场景,DriftWorld 额外在失败案例视频上继续训练。
- DriftWorld 的模拟成功率与真实 MuJoCo 成功率高度一致。
- Lift:相关性 0.9916。
- Can:相关性 0.9250。
- 均优于 Ctrl-World,后者分别为 0.9053 和 0.8562。
结论:
- DriftWorld 不仅能预测策略的绝对性能,也能较准确地保持策略之间的相对排名。
- 可作为真实机器人策略评估的低成本离线模拟器。
消融实验
特征空间消融
- 在 Push-T 和 Robomimic 上,直接在像素空间计算漂移损失已经足够。
- 在真实世界数据集上,使用 DINOv2/v3 特征空间显著更好。
- 如果去掉 DINOv2/v3,直接在 VAE latent 空间计算损失,生成结果明显退化,机器人夹爪变模糊。
- 在 Bridge-V2 上:
- 无特征空间:SSIM 0.856,FVD 168.34
- DINOv2:SSIM 0.892,FVD 13.58
- DINOv3:SSIM 0.892,FVD 6.20
说明:
- DINOv2/v3 特征空间对真实复杂场景非常关键。
- 特征编码器只在训练时用于计算漂移损失,不会拖慢推理。
运动加权与 self-forcing 消融
- 在 RT-1 的自回归生成任务上:
- 无改进:SSIM 0.824,FVD 174.67
- 加入运动加权:SSIM 0.830,FVD 67.88
- 运动加权 + self-forcing:SSIM 0.841,FVD 62.84
说明:
- 运动加权让漂移损失更关注运动区域,显著改善夹爪等动态区域的生成。
- self-forcing 让模型在训练第二阶段以自己的预测作为条件,而不是始终使用真实历史帧,从而进一步提升自回归生成稳定性。
总结
DriftWorld 的实验证明了一个核心结论:单步漂移生成模型可以在机器人世界建模中同时实现高速度和高视觉质量。
关键收获:
- 速度优势明显 DriftWorld 平均比 SOTA 扩散世界模型快约 17×,在某些设置下最快可快数百倍。
- 质量不牺牲 在五个机器人操作环境中,DriftWorld 在多数视觉指标上达到或超过扩散基线。
- 漂移损失是关键 与相同 backbone 的 MSE baseline 相比,DriftWorld 更好,说明漂移损失本身对单步生成质量非常重要。
- 适合推理时动作搜索 在 GPC-RANK 中,DriftWorld 能更快 rollout 大量候选动作,并带来更好的真实执行性能。
- 适合离线策略评估 DriftWorld 的预测成功率 / IoU 与真实环境高度相关,可以作为低成本的离线机器人策略模拟器。
- 三个关键设计很重要
- DINOv2/v3 特征空间:提高真实复杂场景的清晰度。
- 运动加权:避免模型忽略动作,提高动态区域建模能力。
- self-forcing:改善自回归 rollout 的稳定性。
总结
提出了 DriftWorld,一个快速、单步生成的动作条件世界模型。为了将漂移生成模型改造为条件视频生成模型,我们提出了若干关键设计,包括动作条件 U-Net 架构、特征空间整合,以及强化动作跟随机制。
局限性
依赖强大的预训练特征提取器
- DriftWorld 在复杂真实场景中依赖 DINOv2/v3 这类强预训练视觉特征提取器来保持画面清晰度。
- 这意味着模型效果可能受到预训练特征表示质量的限制。
训练阶段显存占用较高
- 漂移框架在训练时需要为每个前向传播生成多个负样本,例如 64 个负样本,用于计算漂移损失。
- 因此,训练时显存需求高于标准扩散模型。
上下文长度和生成窗口受限
- 由于显存限制,每个负样本可使用的上下文帧数和生成帧数都受到约束。
- 这可能影响长时域时间一致性。
长时域一致性仍是未来工作
- 论文提出未来可以通过更长的上下文和生成窗口提升长时程一致性。
- 可能的方法包括使用稀疏历史帧,或使用具有时间压缩能力的 video VAE。