Human-like autonomy emerges from self-play and a pinch of human data
Human-like autonomy emerges from self-play and a pinch of human data
一句话总结
spiced self-play不把人类轨迹混进强化学习,而是先用约 30 分钟 WOMD-SDC 子集训一个冻结 BC 锚点 ,再从零做自我对弈 PPO。任务信号只用稀疏安全到达奖励;人类相容性靠在 的 on-policy 状态上加 ,把策略从「有效但怪异」的均衡拉回人类驾驶公约附近。人类数据是调味,200 亿步合成自我对弈才是主菜。
摘要与引言
自我对弈强化学习(self-play RL)的一个关键局限是:纯自我对弈训练出的策略,可能学到有效却“异类”的驾驶惯例,从而无法与人兼容。 本文并不完全抛弃人类示范,而是将其作为正则化目标,叠加在一个极简的安全到达奖励之上。
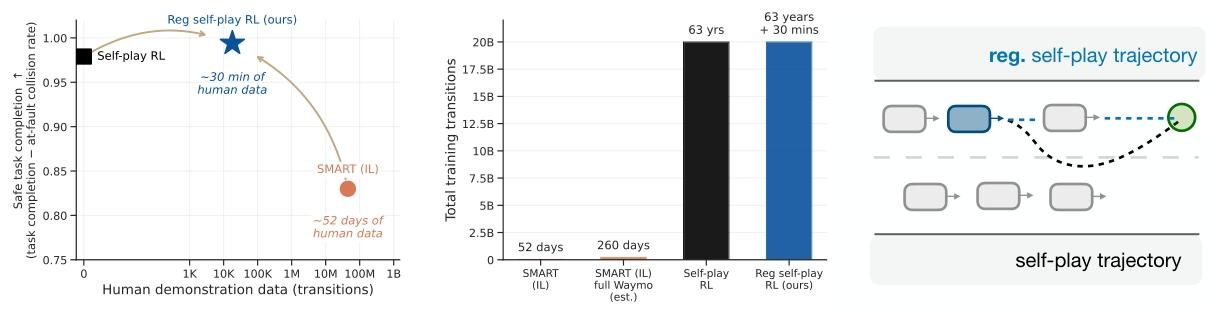 图1:Spiced 自博弈强化学习仅凭30分钟人类数据和60年模拟经验实现类人协调。左:与人类驾驶数据对比的安全任务完成度(任务完成率 − 有责碰撞率),以人类回放代理为评估基准。以约30分钟人类驾驶数据作为行为锚(蓝色五角星,本文方法;0.994),我们的方法优于未正则化自博弈(黑色正方形;0.979)和 SMART-tiny CLSFT(橙色圆形;0.830),后者是在完整 Waymo 数据集上训练的基于模仿学习(IL)的方法。米色箭头表示相对于各基线的提升。中:各方法使用的总训练转移数。两种自博弈变体都消耗200亿次转移(10 Hz 下约63年)的廉价合成经验;SMART 使用4500万–2.25亿条人类记录转移(约52天–7个月;见附录E)。右:示例推演(见视频)。自博弈策略(黑色虚线)驾驶激进,在有间隙时见缝插针;正则化策略(蓝色虚线)耐心等待其他智能体。深蓝色车辆是受控智能体,其目标条件为绿色目标目的地。灰色智能体遵循日志回放。
自我对弈强化学习(RL)已在策略类游戏中训练出超人类智能体,并在自动驾驶等真实世界场景中展现出潜力,绕过了多智能体学习中的核心难点——如何建模对手:智能体的对手就是自己的副本。
但是在自动驾驶这种非零和博弈中,若奖励中未写明约束,一个被训练去“安全到达目的地”的智能体,完全可能学会倒着开、侧着开,甚至开到对向车道。
为了解决这个问题,已有两条路径。
- 手工奖励工程:不断添加奖励项,直到期望行为和惯例出现。这种方法有效,但本质上费力、依赖具体领域,而且脆弱——很难事先知道何种奖励会带来类人行为。
- 模仿学习(IL):策略直接模仿人类驾驶数据,从而完全不必定义奖励函数。但鲁棒性需要广泛的状态覆盖,因此这类方法通常依赖大量人类示范。
本文采取另一条路径,人类数据在协同博弈中的自然角色:不应作为训练信号的主来源,而应作为轻量锚点,把策略从“有效却行为异类”的策略上拉开。
本文首次在自我对弈 RL 中报告了方向相反、幅度相当的现象:少量有益数据会不成比例地改善行为。就像一小撮辣椒就能改变整道菜的味道,少量人类数据似乎也能改变自我对弈策略的行为。据此,我们将这种做法称为 data spicing(数据加料),并将方法命名为 spiced self-play(加料自我对弈)。
具体而言,我们在稀疏的安全到达奖励下训练 PPO 策略,同时将其向一个由少量人类驾驶数据拟合的行为克隆锚点正则化。我们观察到:
- 30 分钟到 3 小时的人类驾驶数据,再配合大规模自我对弈,就足以改善与人类代理的协同,无需奖励工程或域随机化(图 1;第 4.1、4.3 节)。
- 加料策略不仅碰撞率更低,在分布真实性与碰撞严重程度分布上也更接近人类(第 4.2 节)。
- 为便于复现与后续研究,我们开源了完整代码。策略可在单块消费级 GPU 上端到端训练 15 小时完成。
方法
问题设定与指标
问题设定
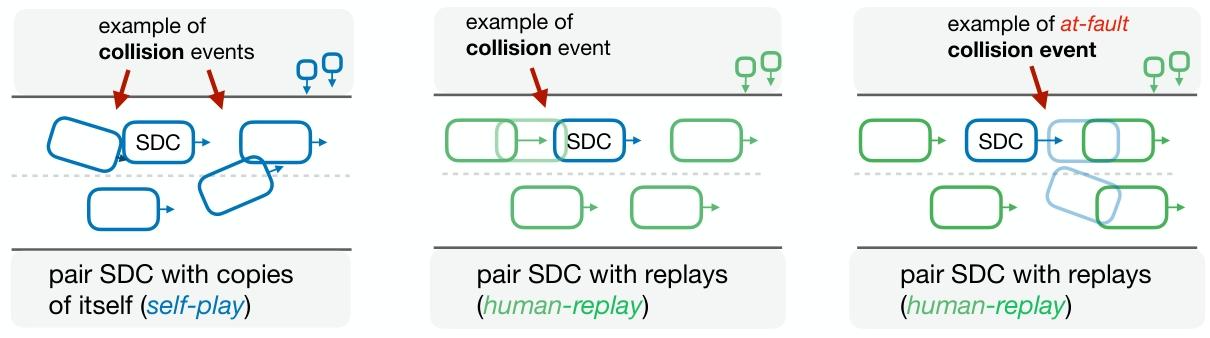 图2:评估设置。自博弈(左)和人类回放(中、右)。红色箭头标记碰撞。矩形表示车辆;方块表示行人。在人类回放中,有些碰撞实际上是不可避免的:回放智能体遵循其记录的轨迹,可能从后方撞上受控自车(SDC)。因此,我们区分碰撞(任何接触)和有责碰撞(由受控智能体造成的接触,遵循 NAVSIM 基准)。
通过在仿真中回放已记录的人类轨迹,来近似与人类道路使用者的交互。评估在三种设定下进行,如图 2 所示:
- 自我对弈(Self-play)。 所有智能体由同一策略以去中心化方式控制。
- 人类回放(Human-replay)。 仅自动驾驶车(SDC)由策略控制,其余智能体沿其日志轨迹运动。
- IDM。 SDC 由策略控制,其余智能体遵循智能驾驶员模型(Intelligent Driver Model):横向沿预先计算的车道中心路径行驶,纵向用 IDM 加速度与前车保持安全间距。
三种设定分别测 对人是否像人、对会反应的车能不能闭环开、自己跟自己是否一致。 人类回放检验策略是否已内化人类驾驶惯例,即使共同参与者不可反应。IDM 引入带反应式规则智能体的闭环动力学。自我对弈检验内部一致性,并作为收敛的健全性检查。
指标
得分(score) 是聚合指标:智能体在回合结束前到达目标、且未碰撞、未驶出道路则记 1,否则记 0。
另行报告 碰撞率、有责碰撞率、驶出道路率 与 路线进度。理想智能体应在自身群体以及人类回放群体上均表现良好。
还用 Waymo Open Sim Agent Challenge 报告 分布真实性,将行为与日志轨迹对比。
也分析有责碰撞的 严重程度
仿真环境
世界初始化
仿真与训练使用 PufferDrive 2.0。环境由 Waymo Open Motion Dataset(WOMD)初始化:每个 9 秒场景提供道路图、可变数量的智能体(汽车、骑行者、行人,最多 ),以及从日志中取出的各智能体初始位姿与目标。 每个智能体以目标目的地 为条件,并接收部分、去中心化、自车坐标系下的观测,包括自身状态、50 m 内最近的 个邻居,以及最多 128 段附近道路片段(路沿、车道与标线)。
奖励函数
为分离人类驾驶数据的作用,我们不做奖励工程,采用稀疏奖励:到达目标 ,碰撞或驶出道路 ,其余为 。
因此,类人行为上的任何差异都来自行为克隆(BC)正则化,而非手工调过的奖励。
加料自我对弈强化学习
加料自我对弈(spiced self-play)是锚定少量人类示范数据(此处为驾驶日志)的正则化自我对弈 RL。
锚点是拟合这些数据的行为克隆策略,通过 KL 惩罚对自我对弈做正则。
训练分两阶段:先用人类数据拟合行为克隆(BC)锚点,再将其冻结,作为自我对弈 RL 的正则项。
训练锚点策略
在完整数据集 的子集上训练锚点策略。
采样对应 个场景的子集 ,大约得到 的人类驾驶数据,并通过最小化负对数似然拟合各锚点 :
每个场景只使用自动驾驶车(SDC)轨迹作为模仿数据,因为它通常质量最高。随后将每个锚点 冻结,用于下一阶段自我对弈。完整细节见附录 A.4。
正则化自我对弈 RL
近端策略优化(PPO)从头训练 。策略 由约 65 万参数的神经网络表示。每个锚点 通过 KL 惩罚充当行为正则项:
其中 是在策略状态分布, 控制正则强度。KL 项把 拉向锚点,作用在策略实际访问的状态上,而非 的离线分布上。超参数与训练细节见附录 A.1 与 B。
实验
实验设置
仿真与数据
- 仿真器用 PufferDrive 2.0,RTX 5090 约 390k SPS。
- 场景来自 WOMD:每段 9 秒、90 步;最多用 50k / 500k 训练场景。
- 最多 N=32 个智能体(车、骑行者、行人);并行约 1024 个 agent。
- 观测去中心化、自车坐标系,维度 1124:自身 + 50 m 内最近 31 个邻居 + 最多 128 段道路。
- 目标条件化:日志终点作为 goal,到达半径 2 m。
训练
- 稀疏奖励:到达 +1,碰撞/驶出道路 -1,其余 0。无奖励工程、无域随机化。
- 两阶段:先训冻结的 BC 锚点 ,再用 PPO 从头训 ,加在线 KL:
- ; 即无正则自我对弈。
- PPO 走 20B 步(10 Hz 约 63 年仿真),单卡消费级 GPU 约 15 小时。
- 策略约 650k 参数(含 LSTM);BC 锚点约 776k,无 RNN。
- 人类数据只取每场景 SDC 轨迹,嵌套子集约为:10 min / 30 min / 3 h / 30 h。
评估设定(三种 complementary 压力测试)
- Self-play:全体同一策略,测内部一致性。
- Human-replay:只控 SDC,其余按日志回放,测是否内化人类惯例。
- IDM:其余为规则反应式智能体,测闭环交互。
主指标
- Score:到达且无碰撞、无驶出道路。
- 碰撞率 / 有责碰撞率(NAVSIM 口径,排除被追尾等)
- 驶出道路率、路线进度
- 类人程度:WOSAC 分布真实性、相对人类轨迹的纵/横向 L2、Δv 碰撞严重度
基线
- 无正则自我对弈:零人类数据下界
- SMART-tiny-CLSFT:同数据尺度的 SOTA 模仿学习;另加全量 500k WOMD(约 52 天)作 IL 上界
实验设计
实验围绕三个问题展开:
- 人类数据该用多少? 固定大规模自我对弈,只改 BC 锚点数据量,对比 SMART。回答:人类数据是主监督,还是只需一点点“调料”。
- 这点数据改的是分数,还是行为? 看碰撞严重度、WOSAC、跟车/让行、相对人类轨迹的纵横向误差。回答:是不是真的更像人、更安全。
- 地图/场景多样性有多重要? 冻结 BC 锚点和奖励,只改训练场景数 {10, 100, 1k, 10k, 50k}。回答:便宜的 metadata(路网、初始位姿)能不能替代大量示范。
额外对照:用“对着日志做单智能体 RL”对比自我对弈,检验 变化的伙伴分布 是否带来鲁棒性。
实验效果
数据缩放
在 10k 留出验证场景上(Table 1):
| 方法 | 人类数据 | Self-play 碰撞 | Human-replay 有责碰撞 | 路线进度 |
|---|---|---|---|---|
| SMART | 30 min | 9.5% | 12.5% | 76.9% |
| SMART | 52 天(全量) | 6.1% | 1.6% | 88.5% |
| 无正则 SP | 0 | 1.0% | 2.1% | 100% |
| 加料 SP | 30 min | 0.2% | 0.7% | 99.8% |
| 加料 SP | 3 h | 0.2% | 0.6% | 100% |
- 30 min 加料 SP 已全面超过全量 SMART:有责碰撞 0.7% vs 1.6%(约 2.5×),人类数据少约 2500×。
- 相对同尺度 SMART(30 min):自我对弈碰撞约 46× 下降。
- 相对无正则 SP:有责碰撞 2.1% → 0.7%(约 3.5×)。再加到 30 小时,收益基本饱和。
- 图 1 的安全任务完成率:加料 0.994 > 无正则 0.979 > SMART 0.830。
为什么 IL 差、自我对弈强:
- SMART 先开环拟合日志,再闭环微调贴近日志分布,从未见过会进化的伙伴。全量 SMART 在 self-play 仍有 6% 碰撞,对日志却只有 1.6%。
- 对着静态日志做单智能体 RL:在日志上很好(有责 0.2–0.3%),但 self-play 变差(0.8–1.2%)。
- 自我对弈提供非平稳、会变强的伙伴分布,更容易形成可迁移的协同惯例。
锚点本身并不强。 30 min BC 闭环 human-replay score 只有 0.371;同一锚点正则后的 RL 到 0.968。说明 RL 不是在复读 BC,而是用稀疏任务奖励把弱先验“纠偏放大”。
行为与安全
碰撞严重度(Δv)
- 次均 2.09 → 1.71 m/s(低约 18%)
- 最大冲击 13.71 → 8.09 m/s
- 超过 15 mph 的碰撞:14.3% → 7.5%
- 低速接触几乎一样,差距主要出现在 >5 m/s 的尾部。
分布真实性
- WOSAC:无正则 0.680 → 30 min 加料 0.725;再加数据几乎不再涨,瓶颈是 BC 锚点质量。
- SMART 最高 0.755,但碰撞和任务完成全面更差。 像日志 ≠ 安全/能干。
驾驶风格
- 无正则:激进、见缝就钻,回合约 38 步。
- 加料:跟车更远、少加塞、路口更让,回合约 64 步。
- 相对人类轨迹误差(Table 2):
- 纵向 L2:13.33 → 5.56 m(速度更像人)
- 横向 L2:2.39 → 1.27 m(路径更像人)
- ADE:14.07 → 5.93 m
一句话:无正则在优化“尽快安全到达”;人类是 satisficing。KL 锚点把策略从“最快”拉回“按时且合惯例”。
场景 metadata
冻结锚点和奖励,只改训练地图数:
- 无正则:有责碰撞 14% @10 张图 → 0.5–1% @50k
- Human-replay 碰撞:25.2% → 2%
- 30 min 锚点:human-replay 有责 14% @10 → 0.7% @50k
- 自我对弈 vs 人类回放的零样本协同差:加料约 0.2%,无正则约 1.5%
含义:路网/初始位姿这种便宜 metadata,对泛化几乎是刚需;人类示范负责“开得像人”,场景多样性负责“换图还能开”。
总结
方法角色分工
- 合成自我对弈:无限便宜,负责能力、覆盖、协同。
- 人类数据:昂贵,只做轻量锚点,负责避开异类均衡。
- 奖励保持极简,避免把“像人”手工写进 reward。
可记的数字
- 30 min 人类数据 + 20B 仿真步 ≈ 全量 WOMD 的 0.04%
- 有责碰撞:2.1%(纯 SP)→ 0.7%(加料)→ SMART 全量仍 1.6%
- 像人:WOSAC 0.680 → 0.725;纵向误差腰斩以上
- 训练:单卡约 15 小时
局限
- 最难 200 个交互场景:有责碰撞从 0.7% 升到 2.1–2.8%, tight coordination 仍不够稳。
- 评估是日志回放 / IDM 代理,不等于上路。
- 锚点熵、闭环质量如何决定最终行为,机制还不清楚。
对方法学习最有用的三点
- KL 作用在 on-policy 状态 上,不是离线日志分布,所以能改“策略真正会走到的地方”。
- 数据效率来自 任务奖励 + 弱先验,不是因为 BC 已经很强。
- 人类数据与地图 metadata 是两类不同资源:前者对齐惯例,后者提供场景覆盖。
总结
通过一系列实验,试图把「人类驾驶数据」与「合成仿真经验」如何混合,放到更可量化、更可复现的科学基础上
核心发现是:大约 30 分钟到 3 小时 的人类驾驶数据,就能显著把策略推向与人类相容的驾驶行为,而且全程 不做奖励工程、也不做域随机化。
当仿真足够便宜、同时又有清晰的目标行为指标时,人类驾驶数据最好不要当主训练信号,而应作为轻量 锚点(anchor),把策略从「有效但怪异」的均衡里拉回来。
局限
- 紧密协调场景下的鲁棒性不足 我们额外构造了 200 个最难的交互场景(并线、无保护左转、让行等,见附录 D.1),复用第 4.1 节的评测。策略排序不变:加料自我对弈仍优于 SMART 与未正则化自我对弈,但 有责碰撞率从 0.7% 升到 2.1–2.8%。这说明策略在硬交互上仍有明显提升空间。 并非所有接触都能算策略失败:有些是回放车辆突然切入 SDC 车道,几乎没有物理上可行的避让。如何在「有责启发式」之外定义公平的避碰基准,本身仍是工业界和学术界的开放问题。
- 评测的外部效度有限 当前评测用 人类回放 和 IDM 控制智能体 作为「与人协调」的代理。这些设定上的表现,能在多大程度上迁移到真实上路,仍是开放问题。
- 对锚点策略的敏感性尚不清楚 把 RL 策略正则化到预训练 BC 锚点,为何能提升类人程度,许多细节仍不完整。例如锚点分布的熵等性质如何影响结果,还不清楚。实验显示正则化策略明显优于其锚点本身(图 9、表 7),说明 RL 至少修正了锚点的部分次优行为。但这种修正对 BC 闭环质量有多敏感、具体如何发生,仍不清楚。
讨论:人类示范与合成仿真经验如何互补
上述发现引出一个更深、目前只刚碰到表面的问题:既然自我对弈经验可以按需生成,那「少量人类数据」的互补价值到底是什么?对某个应用 X、某种结构 Y,我们能否事先预测:该采多少人类数据、采什么类型才值得?
本文大致能直觉到两点:
- 更像人:正则化后的自我对弈策略更像人,因为动作分布被约束在锚点附近(见附录 F.2)。
- 更稳健:策略在训练中见到更广的状态覆盖。自我对弈从随机开局学起,共 200 亿步;而 IL 基线只在约 2.25 亿条固定专家转移上训练(图 1 中)。
但「条数」是很粗的解释:不是每条转移同样有信息量。最近关于 epiplexity 的工作试图形式化「数据价值」,但目前仍是理论量,还不能直接用于实际选数据。发展工具来判断:学某种行为需要什么人类数据、采之前就能预测要多少,是很有前景的后续方向。