Dream-Tac: A Unified Tactile World Action Model for Contact-Rich Robot Manipulation
Dream-Tac: A Unified Tactile World Action Model for Contact-Rich Robot Manipulation
一句话总结
Dream-Tac 把当前视触觉条件、未来视觉、未来触觉和动作放进同一个 DiT 里联合去噪;用接触门控的非对称注意力,在接触转变时强调触觉、避免被稀疏噪声稀释;再用 FlashBias 训练加速和扩散缓存推理加速,使这套世界动作模型能在真机富接触任务上跑起来。
摘要与引言部分
Dream-Tac,一种统一的触觉世界动作模型,联合建模动作、未来视觉观测与触觉动态
引入了:
- (i) 接触门控视触觉融合,用于有选择地整合触觉信号;
- (ii) 接触感知注意力偏置,以更好地调控操作过程中的跨模态交互。
设计了双层加速策略:在训练阶段对接触感知偏置进行重参数化,以保留融合注意力路径;在推理阶段引入基于缓存的扩散加速,从而实现最高 2.9 倍的训练加速和 1.8 倍的推理加速。
代码见。
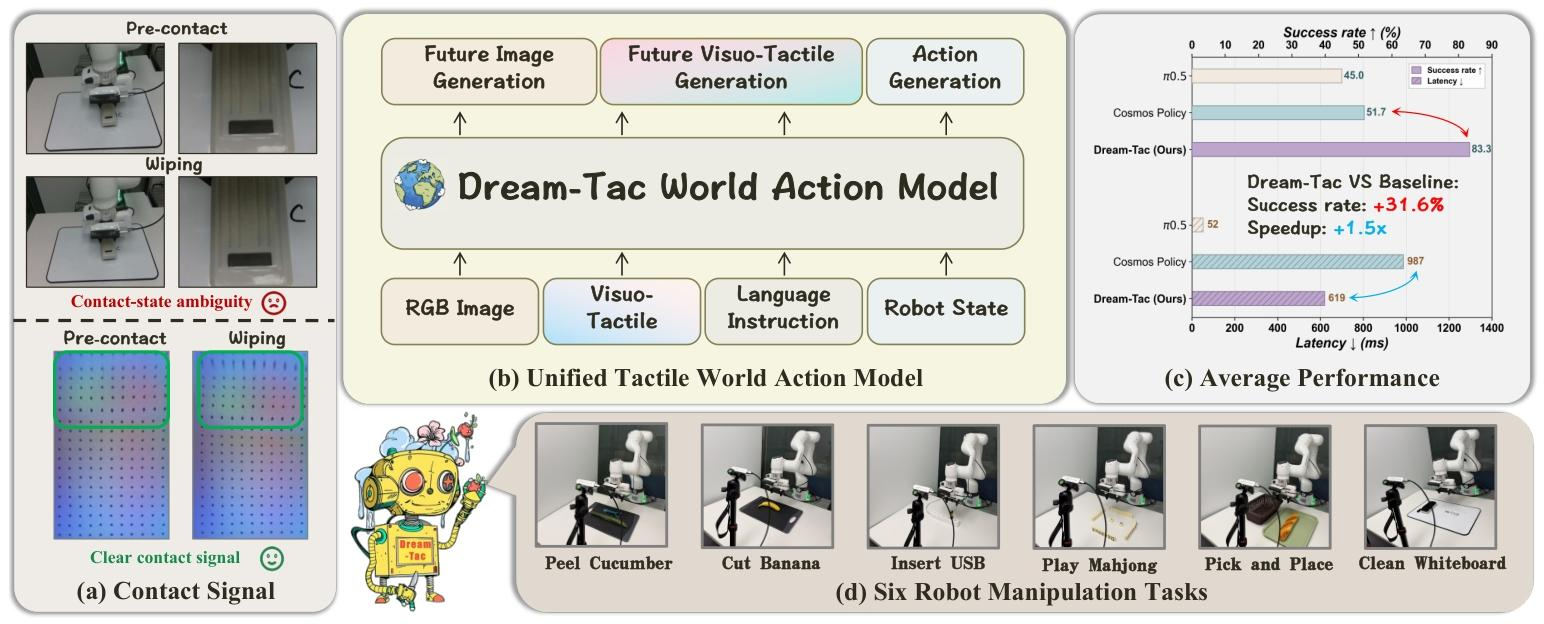 图1:我们工作的概览。(a) RGB与触觉传感在感知接触前后接触状态变化方面的比较。(b) Dream-Tac,一个统一的触觉世界动作模型,包括其输入和输出。(c) 在六个接触丰富的操作任务上与基线方法的比较。(d) 六个任务设置的可视化。
尽管世界动作模型在通用操作任务中已展现出良好性能,但在富接触、精细操作场景中仍存在局限。这一局限很大程度上源于:仅凭视觉往往难以捕捉精确控制所需的物理交互线索,包括接触状态、局部几何以及细粒度物体属性。
如图 1(a) 所示,RGB 图像无法清晰指示是否发生接触,而触觉变化则揭示了细微的物理交互线索,从而补偿视觉在细粒度接触感知上的不足。这使得触觉感知在需要准确把握物理接触的操作任务中尤为重要
将触觉 token 与其他模态对称对待,可能稀释对成功操作最为关键的精确交互线索。这就引出了一个核心问题:如何以选择性、交互感知的方式,将触觉信号融入世界动作模型?
提出 Dream-Tac,一种统一的触觉世界动作模型。它通过联合预测未来视觉观测、机器人动作以及未来触觉观测,将触觉感知融入生成式框架,建立在预训练的视频生成主干网络之上,并通过一种新颖的接触感知注意力偏置,将世界动作建模扩展到富接触操作。
Dream-Tac 并非均匀对待触觉 token,而是优先关注与交互相关的信号,使未来视觉状态、触觉动态与精确动作生成之间形成更紧密的耦合。
Dream-Tac 引入了双层加速系统。首先,我们用基于 FlashAttention 的实现重新表述门控偏置注意力,使训练最高加速 2.94 倍。其次,我们通过扩散步缓存加速推理,在测试时获得 1.8 倍加速
贡献有四点:
- 提出 Dream-Tac,一种统一的生成式世界动作模型,能够联合预测未来视觉观测、触觉信号与机器人动作。
- 提出一种接触感知注意力机制,在显著交互事件中自适应强调触觉信号。
- 开发双层加速系统:训练阶段采用基于 FlashAttention 的门控偏置以实现高效训练,推理阶段采用扩散步缓存以加快推理。
- 在富接触操作任务上的实验表明,Dream-Tac 在成功率上显著优于现有最先进基线,同时保持有竞争力的生成质量与执行效率。
方法
问题形式化
以视觉观测、触觉观测和语言指令为条件的实时机器人操作。令 (o) 表示当前视觉观测,(x) 表示当前触觉观测,(l) 表示任务指令。目标是预测长度为 (H) 的动作片段 (a_{1:H})。
标准视觉运动策略直接根据当前观测和语言指令建模动作:
与此并行,世界模型关注预测未来观测。令 (v_{1:T}) 表示未来 (T) 步的视觉观测。标准世界模型刻画条件分布
即在当前上下文给定时,视觉场景如何演化。 在这两种形式化的基础上,世界动作模型将动作预测与未来观测预测纳入统一框架。具体而言,它联合建模
或等价地将该联合分布分解为
其中未来视觉预测为动作生成提供预测性结构。
Dream-Tac,一种增强的世界动作模型,将触觉感知同时纳入条件上下文与预测目标。令 (x_{1:T}) 表示未来触觉观测。Dream-Tac 联合建模
从而将标准世界动作建模从视觉未来预测扩展为视触觉联合未来预测。该形式化使模型能够在统一框架中同时推理动作生成、未来场景演化以及未来接触动态。
Dream-Tac 架构
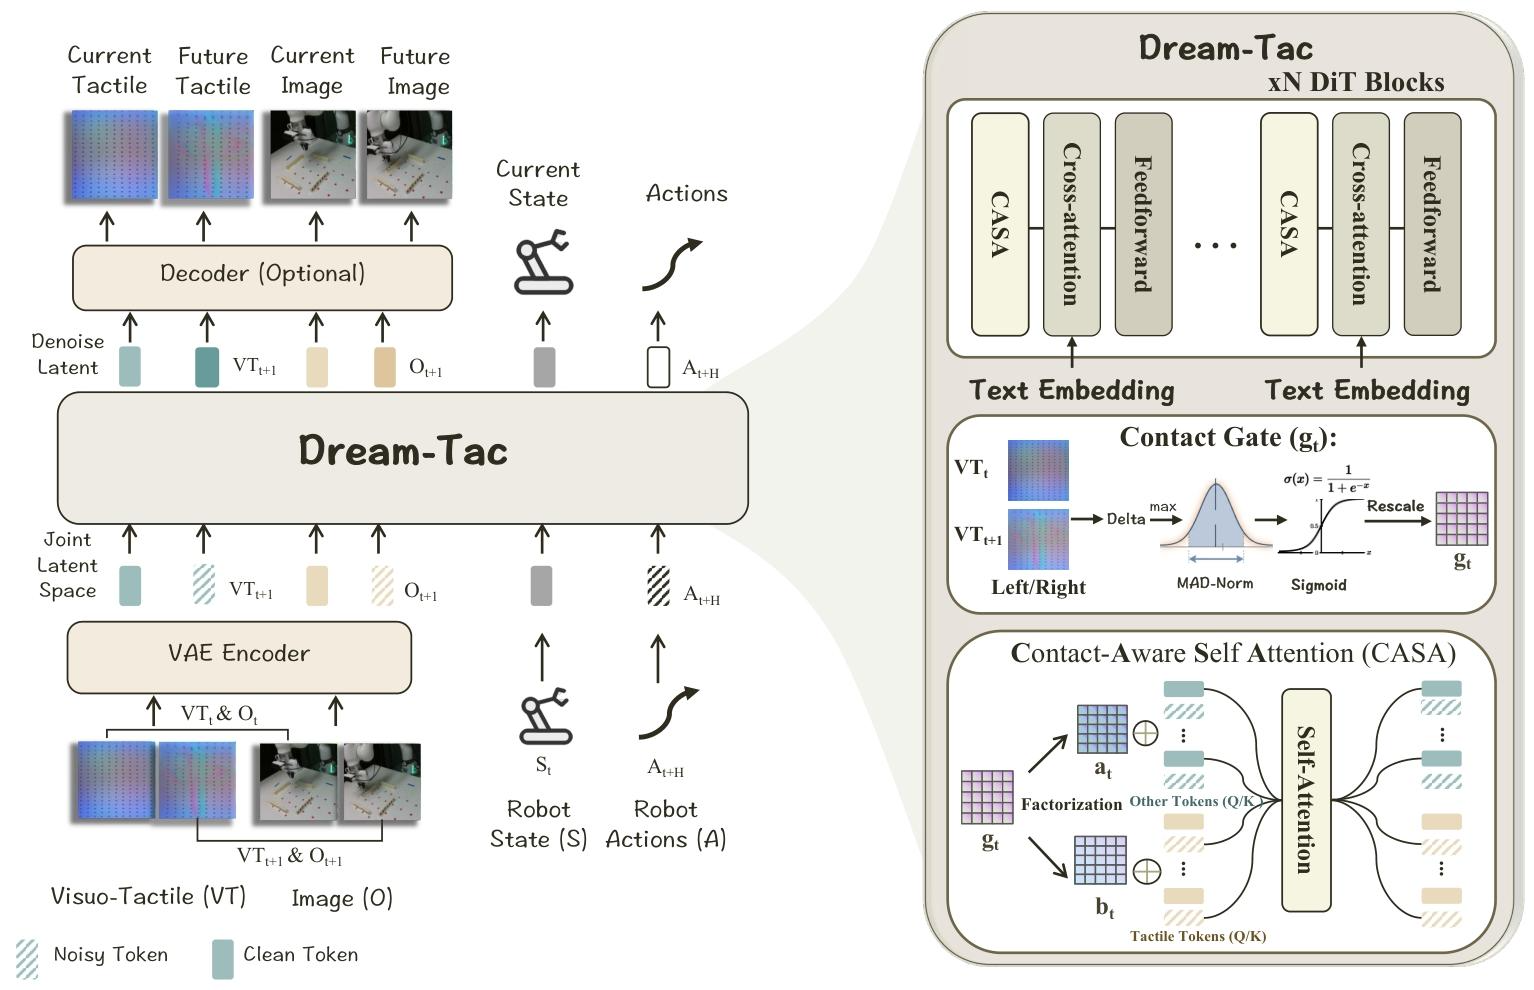 图2:Dream-Tac 概览。Dream-Tac 是一个统一的触觉世界动作模型,能够在共享潜在空间中联合预测未来触觉观测、未来视觉观测和机器人动作。左侧:多模态输入,包括视触觉观测、视觉观测、机器人状态和动作 token,被编码为联合潜在表示,并由共享主干网络处理,随后可选地通过解码进行未来预测。右侧:Dream-Tac 主干网络基于 DiT 块构建,并融入了所提出的接触感知自注意力(CASA)。接触门 (g_{t}) 由逐帧触觉变化计算得到,并用于重新缩放触觉注意力偏置,使模型能够在显著交互事件期间强调触觉信息。
Dream-Tac 建立在预训练的视频扩散 Transformer(DiT)之上,并将其作为世界建模主干。复用其基于网络数据预训练的 T5 文本编码器与视频 VAE。任务语言由 T5 编码器编码,并通过交叉注意力提供给所有 token;视觉观测则由预训练 VAE 编码为潜视频 token。
将机器人状态、动作片段和触觉观测纳入同一潜空间建模框架。 遵循 Cosmos-Policy,机器人状态与动作被表示为填充后的潜帧 token,并插入视频主干中进行联合去噪。Cosmos-Policy 的 latent frame injection:把低维的状态、动作填成和视频潜帧同形状的 token,塞进同一个 DiT 里做自注意力。 为刻画接触感知交互,触觉观测同样通过同一预训练 VAE 映射到该潜空间。实验表明,预训练 VAE 已经能够对不同动作对应的触觉模式形成有意义的潜空间分离,而无需额外的触觉专用预训练。
这种统一的潜表征使 Dream-Tac 能够在单个扩散 Transformer 中联合建模视觉动态、触觉动态与动作生成,同时保留预训练主干的稳定性与先验。
该设计的一个重要优势是:触觉信号可以直接被共享 Transformer 访问。
接触感知自注意力
富接触操作中的触觉信号通常稀疏且短暂:它们会在很长时间内几乎保持不变,而接触发生、滑移或释放则会引起急剧的局部变化。在对称注意力下,非接触时间步仍可能关注触觉 token,导致弱相关的触觉信息不断累积,从而削弱模型对接触状态变化的敏感性。
引入一种门控注意力机制,在接触事件发生时放大触觉信号。
带门控结构化 logit 偏置的注意力
保留标准的线性投影与 value 聚合,并在注意力 logit(注意力机制中、经过 softmax 归一化之前的未归一化分数。有时也叫 attention score / attention logits。) 上加入标量门控加性偏置,使非触觉 query 能够根据由数据得到的接触事件强度,增强对触觉 key 的关注。
令 (i,j) 为展平后的 token 下标,(M_i\in{0,1}) 表示 token (i) 是否属于触觉 token。对每个输入序列和时间步 (t),我们计算门控 (g_t\in[g_{\min},g_{\max}])(定义见下文)。注意力 logit 为
其中 (d) 为注意力头维度,(\alpha>0) 控制偏置幅度。该偏置仅在非触觉 query((M_i=0))关注触觉 key((M_j=1))时生效,从而形成非对称归纳偏置:在接触动态显著时,鼓励动作、本体感觉和视觉 token 获取触觉信息,同时保持触觉–触觉交互不变。注意力权重由 (a_{ij}=\operatorname{softmax}j(\operatorname{logit})) 计算,随后进行标准的 value 聚合。
门控计算
门控 (g_t) 衡量轨迹中相邻时间步之间的触觉变化幅度,直接使用原始触觉 RGB 帧,而不引入额外的可学习门控网络。令 (IL_t,IR_t\in{0,\ldots,255}^{H\times W\times 3}) 表示夹爪上传感器在时刻 (t) 获得的左、右触觉图像。对每个视角,我们计算相对前一帧的归一化平均绝对差:
其中 ((p,c)) 索引空间位置与 RGB 通道。我们将每步事件强度定义为
因此任一触觉视角出现显著变化都会提高门控。对没有前驱帧的初始时间步,我们设 (\rho_0=0)。 为抑制无害传感器噪声同时保留显著接触事件,我们通过固定的鲁棒归一化将 (\rho_t) 映射为有界门控:
其中 (m) 和 (s) 是固定的位置与尺度超参数(采用 median/MAD 风格归一化,而非从每个数据集估计),(k) 控制 sigmoid 锐度,(\epsilon) 保证数值稳定。实现中 ((m,s,k,\epsilon)=(0.002,0.001,4,10^{-6})),并在 sigmoid 前将 (z_t) 裁剪到 ([-30,30]),以避免极端饱和。因此,微小背景波动会使 (g_t\approx g_{\min}),而明显的帧间触觉变化会将 (g_t) 推向 (g_{\max}),从而在接触动态更可能发生变化时增强式 (6) 中的定向偏置。(g_{\min}) 和 (g_{\max}) 不是从数据学出来的,而是作者手设的门控输出上下界。附录 A.6 写明:
由于该门控仅由观测到的触觉输入、对每个样本和时间步独立计算,因此可同时用于训练与推理,而不会引入特权的未来信息。
训练目标
Dream-Tac 采用与底层预训练视频模型相同的潜空间去噪目标。给定当前视觉观测 (o)、当前触觉观测 (x) 和语言指令 (l),我们在统一潜序列中联合建模未来视觉观测 (v_{1:T})、未来触觉观测 (x_{1:T}) 以及动作片段 (a_{1:H})。
视觉观测和触觉观测由预训练 VAE 编码为潜 token,机器人动作则按潜注入方式表示为潜帧 token。令 (y={zv_{1:T},zx_{1:T},z^a_{1:H}}) 表示目标潜变量,其中 (z^v_{1:T}) 为未来视觉观测的潜 token,(z^x_{1:T}) 为未来触觉观测的潜 token,(z^a_{1:H}) 为潜动作 token。训练时,我们采样高斯噪声 (\epsilon\sim\mathcal{N}(0,I)) 和噪声水平 (\sigma\sim p(\sigma)),并构造被污染的潜序列
扩散 Transformer 被训练为:在干净前缀上下文(由当前观测和语言组成)以及被污染潜序列的条件下,预测去噪目标。沿用预训练主干的标准去噪目标,训练损失写为
其中 (f_\theta) 表示 Dream-Tac 主干。 由于 Dream-Tac 在同一潜空间中联合建模动作、未来图像和未来触觉信号,该去噪目标同时监督动作生成、未来视觉预测和未来触觉预测。为清晰起见,目标也可分解为模态特定项:
其中 (\mathcal{L}{\mathrm{act}})、(\mathcal{L}{\mathrm{img}}) 和 (\mathcal{L}_{\mathrm{tac}}) 分别对应动作、未来视觉和未来触觉潜 token 上的去噪损失,(\lambda_v) 与 (\lambda_t) 用于平衡三项目标。
效率设计
为使 Dream-Tac 能够实际用于实时机器人部署,引入系统级加速模块。
遵循 FlashBias,在 FlashAttention 之上以低秩偏置形式重新实现所提出的接触感知门控偏置注意力。 引入扩散步缓存策略,将有效推理步数降至 2,同时保持性能。
实验
论文用真实机器人验证四件事:触觉融合是否有效、接触感知注意力是否必要、模型是否更泛化、加速后是否还能实时跑。
实验设置
平台:Franka Emika Panda,桌面操作。 视觉:两台同步 RealSense D435i,第三人称全局相机 + 腕部近景相机。 触觉:夹爪指尖两枚 Xense Photon,输出左右触觉 RGB。 数据:SpaceMouse 遥操作,每任务 100 条 demo,30 Hz 同步记录第三人称图、腕部图、触觉图、本体感觉。 训练:从 Cosmos-Predict2-2B Video2World 微调;动作 chunk (H=20);CASA 偏置强度 (\alpha=2.0);门控范围 ([g_{\min},g_{\max}]=[0.15,1.0])。Cosmos-Policy 用同一套训练配置,保证对比公平。 评测:每方法每任务 20 次真实试验,报最优 checkpoint 成功率;物体位置在预定范围内随机初始化,超时算失败。
实验设计
| 任务 | 成功标准 | 设计意图 |
|---|---|---|
| Pick Baguette | 面包完全入篮且篮子无明显移动 | 粗操作/可变形抓取对照 |
| Insert USB | USB 完全插入排插 | 高精度对准 + 插入阻力 |
| Clean Whiteboard | 字迹人眼不可见,且橡皮放回原位 | 持续接触力控制 |
| Peel Cucumber | 削下的皮长于 5 cm | 连续接触、力与贴合 |
| Play Mahjong | 判断是否胡牌,并执行正确动作 | 刻意完全遮挡视觉,几乎只靠触觉 |
| Cut Banana | 切割深度超过 5 cm | 接触发生与施力调节 |
四类对照:
- 方法对比:(\pi_0)、(\pi_{0.5})、ForceVLA(力/力矩)、Cosmos Policy(视觉世界动作模型)。
- 模块消融:仅视觉 WAM → 加触觉 → 再加 CASA 偏置。
- OOD:桌高、空间摆放、物体外观、背景。
- 效率:训练加速(FlashBias)+ 推理加速(扩散步缓存)。
实验效果
主实验
(每任务 20 次,成功率 %)
| 方法 | 面包 | USB | 白板 | 削黄瓜 | 麻将 | 切香蕉 | 平均 |
|---|---|---|---|---|---|---|---|
| (\pi_0) | 85 | 0 | 10 | 35 | 25 | 30 | 30.8 |
| (\pi_) | 100 | 5 | 20 | 55 | 30 | 60 | 45.0 |
| ForceVLA | 80 | 0 | 30 | 90 | 55 | 50 | 50.8 |
| Cosmos Policy | 100 | 15 | 55 | 65 | 35 | 40 | 51.7 |
| Dream-Tac | 100 | 35 | 90 | 85 | 100 | 90 | 83.3 |
读结果时抓住三点:
- 粗任务大家都会:Pick Baguette 多数基线已经很高,说明强视觉 + 基本运动控制就够。
- 真正拉开差距的是精细接触:USB、切香蕉、擦白板。这些任务依赖接触发生、对准和施力,而不是“看一眼再动”。
- 麻将是最强证据:视觉被完全挡住后,Dream-Tac 仍 100%;作者认为 CASA 让策略更依赖触觉,而 ForceVLA 仍容易退回视觉/状态先验。
消融
六任务平均成功率:
| 变体 | 触觉 | CASA 偏置 | 平均成功率 |
|---|---|---|---|
| Visual WAM | 否 | 否 | 51.7% |
| Visuo-tactile WAM | 是 | 否 | 74.2% |
| Visuo-tactile WAM + Bias | 是 | 是 | 83.3% |
对应方法结论:触觉融合是主增益(+22.5 pp),CASA 再挖接触线索(+9.1 pp)。 OOD(对比 Cosmos-Policy):
- 削黄瓜改桌高:Dream-Tac 85/90/75,Cosmos 65/30/0。
- 麻将换牌面:Dream-Tac 100→85,Cosmos 35→15。
- 切香蕉换背景:Dream-Tac 90→70,Cosmos 40→25。
- 面包换摆放:两边一样,都是 100→80。 说明:和接触相关的变化上优势更大;纯空间摆放这种更偏视觉的扰动,两边差不多。
效率
训练:完整触觉 + 偏置设定下,80.82 s → 27.48 s,约 2.9×。瓶颈不是触觉 token,而是结构化 logit 偏置破坏了 FlashAttention;低秩重写后才能保住 fused attention。 推理:10 步去噪 1109 ms / 85%;加 timestep cache 后 619 ms / 仍 85%,约 1.8×,成功率不掉。
总结
提出 Dream-Tac,一种面向富接触操作的统一触觉世界动作模型。联合建模动作、未来视觉观测与触觉动态,从而更好地捕捉对操作至关重要的物理交互。
接触门控视触觉融合与接触感知注意力偏置,使模型能够在关键接触转变时有选择地强调触觉信息;同时,双层加速设计使该框架更适合实时部署。
总体而言,实验结果验证了统一视触觉世界建模的有效性,并为在富接触环境中构建更强的机器人系统指出了一个有前景的方向。
局限性
任务覆盖有限。只在有限的真实富接触任务上验证,向更广任务族、更多物体、更复杂环境的泛化仍待确认。 接触建模偏简单。CASA 的门控主要靠相邻帧触觉 RGB 变化,可能抓不住更细微、或跨更长时间的交互模式。 仍然偏贵。加速后比原来快,但扩散式世界动作模型仍明显重于轻量反应式策略。
作者给出的后续方向也很清楚:扩大视触觉数据、做更强的接触建模、继续提速,并扩展到灵巧多阶段操作、可变形物体、长时程富接触任务。
与其他触觉wam对比
| 论文 | 它到底是什么 | 触觉的身份 |
|---|---|---|
| VT-WM | 视触觉世界模型,CEM 开环规划 | 把想象钉在接触物理上 |
| ViTacWorld | 动作条件视触觉世界模型,做数据增强/评估 | 额外生成视角,用来做梦境轨迹 |
| Dream-Tac | 统一 WAM,一个 DiT 联合去噪 | 条件 + 未来预测目标,接触时再放大 |
| VT-WAM | 三专家 WAM,联合 flow matching | 触觉形变动力学,专门路由给动作 |
| TacPAC | WAM 规划 + 执行中校正 | 先想象接触,再拿真触觉对照改后缀 |
| DeCAL | 灵巧手 VLA,隐式世界模型 | 门控注入当前触觉,并在 latent 里共想象未来 |
这六篇其实在回答同一个问题:触觉很关键,但稀疏、局部、常常被视觉盖掉,那它到底该以什么身份进模型? 按你博客里的笔记,可以分成四条路,而不是六篇各玩各的。
前两篇还不是策略;中间三篇是触觉 WAM;DeCAL 是 VLA 侧的平行演化。
触觉怎么引进去
共同前提都一样:RGB 看不清接触,触觉能看清,但有效信号只在接触那一小段。
分叉从“引进去之后干什么”开始:
只预测未来触觉,不直接出动作
VT-WM、ViTacWorld。触觉改善动力学,动作另走规划或下游策略。未来视觉、未来触觉、动作一起生成
Dream-Tac、VT-WAM。这是标准触觉 WAM。预测还不够,执行中要对着预期改动作
TacPAC。明确把 Dream-Tac 这类“有预测、无执行修正”当成前序。当前触觉门控进 VLM,未来视触觉在 latent 里想象
DeCAL。不走像素级 WAM,走理解-想象-动作三专家。
四条流派
流派 A:接触锚定的世界模型
VT-WM、ViTacWorld。
- 共同信念:视觉世界模型会幻觉(物体消失、没碰上却乱动)。触觉是接触消歧器。
- VT-WM:Cosmos + Sparsh,预测下一视觉/触觉状态。规划代价只用视觉目标距离,触觉不进 cost,只让 rollout 更物理。CEM 开环下真机。
- ViTacWorld:把触觉当成和主相机、腕部相机并列的生成流,用流身份标识(stream identity)和跨视角注意力。目标不是当场控机器人,而是规模化生成视触觉 rollout,去增强策略、做上机前评估。
一句话:A 派解决的是“想象靠不靠谱”,还没把触觉接到动作头上。
流派 B:触觉动力学耦合进 WAM
Dream-Tac、VT-WAM。
共同诊断几乎逐字相同:
- 触觉稀疏、短暂;
- 视觉每帧都密;
- 对称融合会视觉主导,触觉被稀释。
不同的是“怎么不让它被稀释”:
| Dream-Tac | VT-WAM | |
|---|---|---|
| 结构 | 一个共享 DiT | 视觉/触觉/动作三 expert |
| 触觉进法 | 和 RGB 共用视频 VAE,当 token 一起去噪 | 单独触觉 expert,预测形变 |
| 反稀释 | CASA:帧差门控 + 非对称 logit 偏置 | 非对称 MoT:动作只读第一帧视觉锚点 + 完整触觉序列 |
| 训练额外招 | 几乎没有,门控是固定公式 | AVTAG:接触阶段 hinge ranking,逼动作更看触觉 |
| 推理 | 仍联合去噪未来视触觉和动作 | visual-cache,部署时丢掉未来视觉 |
| 加速 | FlashBias + 扩散缓存,这是它的第三贡献 | 靠非对称读出省未来视觉 |
Dream-Tac 是 共享主干里“何时听触觉”;VT-WAM 是 专家结构里“动作该读谁”。
两边消融也同构:加触觉涨最多,再加接触引导再涨一截。VT-WAM 还多打了一枪:只看第一帧触觉会比纯视觉更差,说明关键是触觉时序,不是“有张触觉图”。
流派 C:预测-对照-校正
TacPAC。
它承认 B 派的前提,但加了一句更狠的:chunk 一开始执行,接触转变往往还没发生。未来视角损失会被静止触觉帧主导,规划时预测到了,执行中也改不了。
于是拆成两段:
- 基座 WAM 联合生成未来视触觉和 (\hat{a}),让规划条件化于“我以为会摸到什么”;
- 把这份预期接触和规划缓存成 KV;
- 每来一张真触觉,触觉专家对照 cache 出 (\Delta a),只改未执行后缀。
消融把流派差钉死了:只预测大约只拿到完整收益的 1/3;有预测有校正但不看 cache,掉 17 个点。它在实验里也直接对比了 Dream-Tac:Dream-Tac 赢易损物体、输插入;T-Rex 相反。缺口正好是“不能执行中改” vs “没有预期接触可对照”。
流派 D:VLA 里的门控触觉 + latent 共想象
DeCAL。
和 B 派共享两个零件:接触门控、未来视触觉。但骨架是 VLA:
- 理解专家:Qwen3-VL + 残差门控触觉;
- 生成专家:在 latent 里联合预测未来视觉和触觉;
- 动作专家:臂和灵巧手 factorized flow matching。
触觉形态也最满:原图、6D 力、形变图。门控来自全局触觉 token,不是 Dream-Tac 那种固定帧差公式。消融同样显示:简单把触觉拼进 VLM 会干扰视觉;要自适应注入,并且未来视触觉都得想。
同与不同,收成几条
相同:
- 都认为触觉不该只是 policy(策略) 的额外输入。VT-WAM 写过:OmniVTLA 把触觉当输入,表面任务甚至变差。
- 都在处理稀疏接触:要么门控,要么非对称读,要么执行中对照。
- 接触相关任务拉开差距,自由空间/粗操作大家都会。
按“闭环发生在哪”这条轴看:
| 开环想象 | 生成时条件化动作 | 执行中对照预期 |
|---|---|---|
| VT-WM | Dream-Tac / VT-WAM | TacPAC |
| ViTacWorld(数据) | DeCAL(VLA chunk) | — |
再按一条轴:触觉有没有成为动作的一等公民。
- VT-WM:有预测,规划不用触觉。
- ViTacWorld:有预测,动作在下游。
- Dream-Tac / VT-WAM:动作和未来触觉一起训。
- TacPAC:动作先按预期接触规划,再按实际接触修正。
- DeCAL:动作看当前门控触觉 + 未来视触觉 latent。
谱系
可以看成一条进化链:
- VT-WM:加触觉,让世界模型别幻觉。
- ViTacWorld:把这套视触觉 WM 做大规模成数据引擎。
- Dream-Tac / VT-WAM:别只规划/做梦,把触觉动力学直接耦合进动作。两者是同一代的两种融合配方。
- TacPAC:B 派还是开环 chunk,把“预期接触”变成执行时的参照。
- DeCAL:同一套门控 + 共想象,搬进灵巧手 VLA,不走像素 WAM。
触觉 WAM 现在不是“加不加触觉”,而是三件事有没有做全:未来触觉有没有被预测、动作有没有在接触阶段被强制去看它、执行中实际触觉能不能拿来对照那份预期。Dream-Tac 和 VT-WAM 做了前两件;TacPAC 补了第三件;VT-WM / ViTacWorld 停在第一件;DeCAL 用 VLA 把前两件做进了灵巧手。
flowchart TB
  Q["共同问题<br/>视觉看不清接触<br/>触觉稀疏,容易被视觉盖掉"]

  Q --> A
  Q --> D

  subgraph A["A  接触锚定世界模型"]
    direction LR
    VTWM["VT-WM<br/>预测下一视觉 / 触觉状态<br/>CEM 开环规划,触觉不进代价"]
    VITAC["ViTacWorld<br/>动作条件生成视触觉 rollout<br/>用于数据增强和策略评估"]
  end

  A -->|"想象更物理,但动作还在模型外面"| B

  subgraph B["B  触觉动力学耦合 WAM"]
    direction LR
    DT["Dream-Tac<br/>一个 DiT 联合去噪<br/>CASA:接触时放大触觉"]
    VW["VT-WAM<br/>视觉 / 触觉 / 动作三专家<br/>非对称读出 + AVTAG"]
  end

  B -->|"chunk 一开始,接触转变往往还没发生"| C
  B -.->|"门控 + 共想象搬进 VLA"| D

  subgraph C["C  预测-对照-校正"]
    TP["TacPAC<br/>先按预期接触规划并缓存<br/>真触觉对照后只改未执行后缀"]
  end

  subgraph D["D  灵巧 VLA 平行线"]
    DC["DeCAL<br/>当前触觉门控注入 VLM<br/>未来视触觉在 latent 里共想象"]
  end