VT-WAM: Visual-Tactile World Action Model for Contact-Rich Manipulation
VT-WAM: Visual-Tactile World Action Model for Contact-Rich Manipulation
一句话总结
VT-WAM 用联合 flow matching,让视觉、触觉、动作三个 expert 各自预测本模态的速度场:未来腕部图像、未来触觉形变、未来动作块。三路在同一个主干里一起训,但不是互相条件化。非对称 MoT 用注意力 mask 规定读出关系:动作在训练和推理时都只读「第一帧视觉锚点 + 完整触觉序列」。AVTAG 不改这套结构,只在训练的接触阶段加一条 hinge ranking loss,逼动作 query 的相对触觉注意力不低于相对视觉注意力。
摘要与引言
接触丰富的操作要求策略能对局部形变、压力、滑移和摩擦做出反应,但这些线索在时间上很稀疏,而且常常在视觉观测里看不见。
提出 VT-WAM,一个视觉-触觉世界动作模型,在统一的 flow matching 框架里联合学习未来视觉预测、触觉形变预测和动作预测。具体来说,它引入两点:
- 非对称 Mixture-of-Transformers(MoT)注意力,把第一帧视觉锚点与时序触觉动力学桥接起来;
- 接触门控的 Action-Visual-Tactile Attention Guidance(AVTAG),促使动作 query 在接触阶段更依赖触觉证据。
项目页:https://vt-wam.github.io/
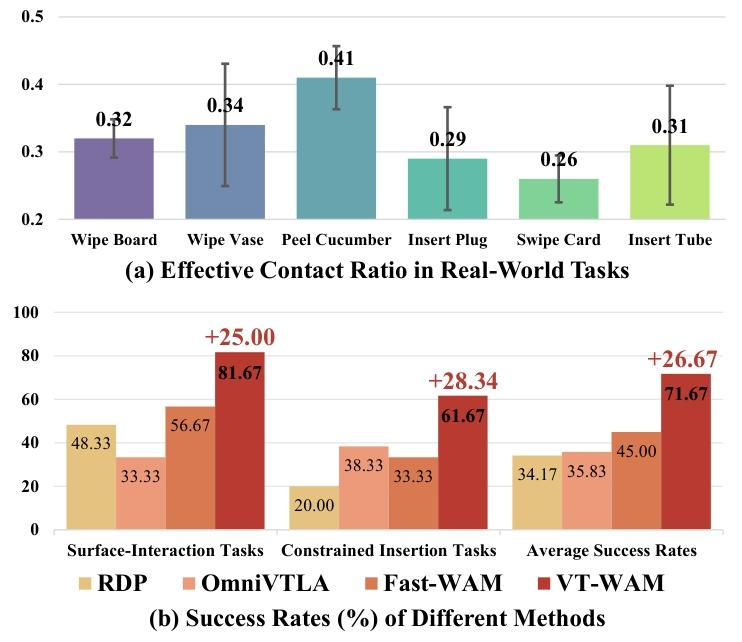 图1. 稀疏触觉动力学为接触丰富的操作提供了决定性证据。(a) 在六个真实世界任务中,触觉响应主要出现在短暂的接触事件附近,使得有信息量的信号在时间上呈稀疏分布。(b) 通过将动作预测与触觉形变动力学耦合,VT-WAM 将平均成功率从 Fast-WAM 的 45.00% 提升至 71.67%,并在表面交互和约束插入任务上均取得一致提升。
具体来说,触觉形变只会在短暂接触阶段演化并提供力反馈,如图 1(a) 所示。相比之下,视觉观测在大多数帧上都提供稠密的场景级信息。这种信息可用性上的时间不平衡,会让神经网络在联合训练时更偏向视觉证据,触觉信号则被低估、用不够。
本文的关键想法是:把动作预测和触觉演化耦合起来,让策略能在接触阶段利用触觉变化。
VT-WAM 有两个核心模块,用来让触觉动力学真正服务于动作预测。
- 非对称 MoT 注意力:把动作 token 路由到第一帧视觉锚点以获取场景上下文,同时路由到完整触觉序列以捕获接触演化。这样可以走 visual(视觉的)-cache 推理模式,同时不丢掉接触阶段所需的触觉动力学。
- 接触门控 AVTAG:用一个仅训练时使用的 hinge ranking loss,进一步减轻视觉主导偏差,促使动作 query 在接触阶段关注触觉证据。这套辅助引导会让模型在接触信息物理上更有用时,更依赖触觉动力学,而且不改变推理时的网络结构。
Hinge ranking loss 中文常叫合页排序损失 / 边界排序损失 / 成对合页损失,是一种用于学习“相对排序”的损失函数。它的核心目标是:
让正样本对的得分比负样本对至少高出某个边界(margin),否则就惩罚模型。
主要贡献如下:
- 提出 VT-WAM,通过视觉-触觉-动作联合 flow matching,把触觉形变动力学与动作预测耦合起来。
- 引入非对称 MoT 注意力和 AVTAG,实现视觉锚点、时序触觉动力学,以及接触阶段的触觉引导。
- 在 6 个真机任务上验证,平均成功率 71.67%,比 Fast-WAM 高 26.67%;消融实验确认两个设计都有效。
方法
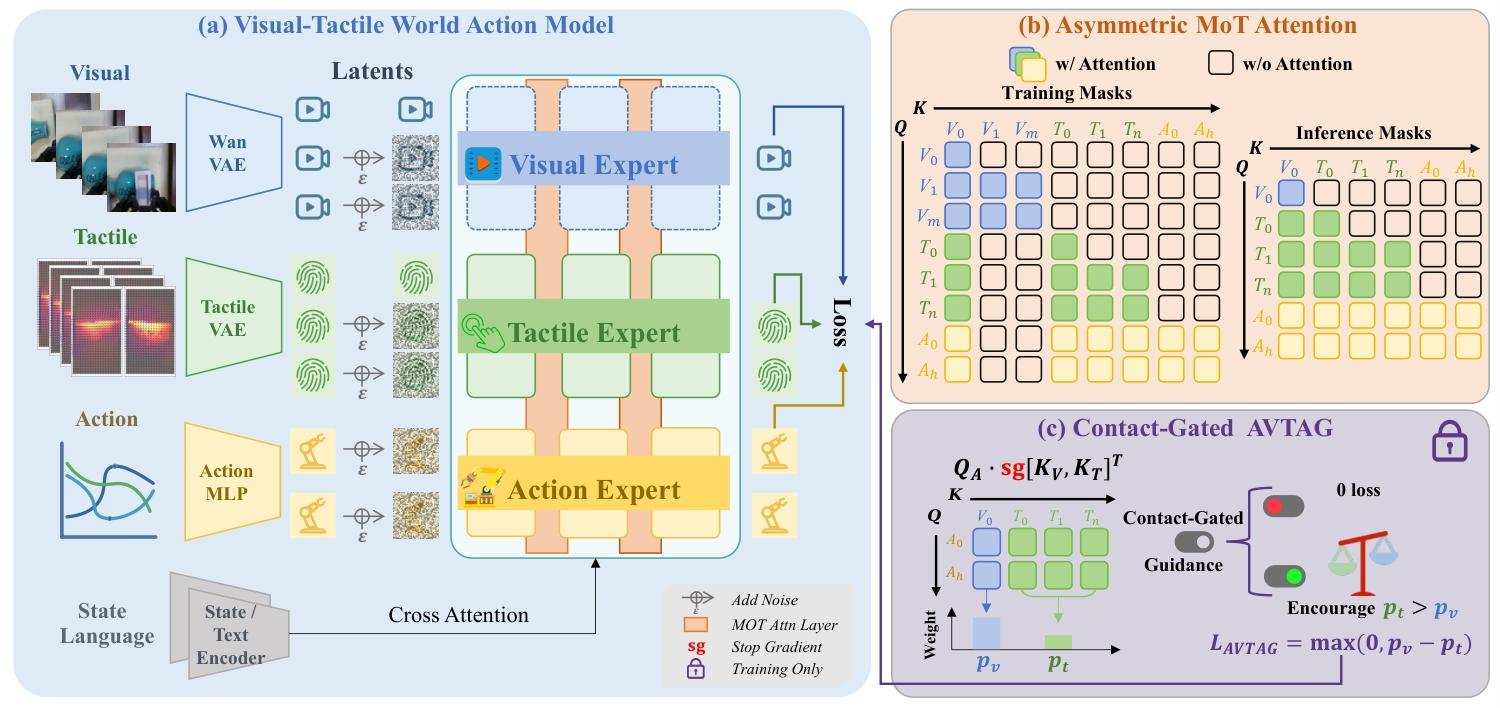 图2. VT-WAM 概览。(a) 联合视觉-触觉-动作流匹配,其中三个模态专用专家通过非对称 MoT 注意力连接。(b) 训练和推理期间非对称 MoT 注意力中的注意力掩码。(c) 接触门控 AVTAG 采用一种仅在训练时使用的合页排序损失(hinge ranking loss),鼓励动作查询在接触阶段优先关注触觉证据。
给定腕部相机观测 (O_v)、触觉形变观测 (O_t)、本体感觉状态 (s)、语言指令 (c) 和动作块 (A),它在统一的 flow matching 框架里联合学习未来视觉预测、触觉形变预测和动作预测。
VT-WAM 的结构
如图 2(a),模型采用视觉-触觉-动作三 expert(专家) 结构:
- 视觉 expert:编码腕部相机 token,作为全局场景上下文
- 触觉 expert:从触觉形变 token 建模局部接触演化
- 动作 expert:根据视觉和触觉证据预测动作块
非对称 MoT 注意力把三个 expert 连起来,使视觉、触觉、动作能在同一个主干里联合预测。
各模态先映射成 token 序列:
- 腕部相机序列 (O_v \in \mathbb{R}^{T_v \times 3 \times H \times W}),经 Wan2.2 video VAE 编码并 patch 化,得到视觉 token (X_v \in \mathbb{R}^{N_v \times d})
- 触觉形变序列 (O_t \in \mathbb{R}^{T_t \times 6 \times H_t \times W_t}),包含两个触觉表面的 3D 形变场。按 OmniVTA ,用预训练触觉 VAE 编码为 (X_t \in \mathbb{R}^{N_t \times d})
- 动作块 (A \in \mathbb{R}^{S_a \times D_a}) 线性投影为 (X_a \in \mathbb{R}^{S_a \times d})
- 语言指令和本体感觉通过 cross-attention 提供给每个 expert
在第 (l) 层非对称 MoT 注意力中,每个 expert 从自己的 token 流计算 Q/K/V,再按视觉、触觉、动作顺序拼接:
随后对拼接后的 token 做带 mask 的注意力:
其中 (P^{(l)}) 是视觉/触觉/动作 token 上的注意力图,(M) 决定哪些 query 能看哪些 key。(Y^{(l)}) 是更新后的三类 expert 特征。
(M) 的作用是:有些格子直接封死。封死的位置,softmax 后权重约等于 0,等于“这个 query 不许看那个 key”。
经过这些层后,各模态投影头在 flow matching 目标下预测对应速度场:视觉和触觉 expert 在训练时监督未来视觉预测和触觉形变预测,动作头则产出用于控制的动作块。
非对称 MoT 注意力
控制 MoT 层里视觉、触觉、动作 token 如何交换信息。设计来自接触丰富控制的两个需求:
- 腕部相机主要提供全局场景上下文,触觉形变才是接触交互的关键证据,所以动作预测应看到完整触觉序列,以捕获接触演化。
- 触觉动力学对控制很重要,但把未来视觉 token 去噪会带来不必要的部署延迟。
因此 VT-WAM 采用非对称读出:动作 token 看完整触觉序列以获取接触动力学,但视觉只看第一帧视觉锚点作为全局上下文。
图 2(b) 给出训练和推理时的实现:
- 训练:视觉、触觉、动作三条支路都留在同一个联合 flow matching 模型里,一起优化未来视觉、触觉和动作预测。
- 推理:去掉未来视觉 token。触觉和动作支路使用第一帧视觉锚点,动作 token 关注正在去噪的触觉 latent 序列。这样既保留接触动力学建模,又避免未来视觉预测的开销。
下面形式化这套跨模态 mask。视觉 token 分成第一帧视觉锚点和未来视觉 token。记:
- (F_v):第一帧视觉 token 数
- (N_v):全部视觉 token 数
- (N_t):触觉 token 数
- (S_a):动作 token 数
token 按 ([X_v; X_t; X_a]) 打包,并施加分块注意力 mask (M):行是正在更新的 query,列是可作为信息源的 key。0 表示允许注意力,-1 表示阻断。 同模态注意力在各自 expert 内保留,跨模态规则如下。
视觉 expert:屏蔽触觉和动作 key,避免局部接触形变和未来动作改写视觉表示:
触觉 expert:视觉 key 里只看第一帧视觉锚点,把触觉动力学锚定在全局场景上下文上,同时不依赖未来视觉 token;动作 key 也屏蔽:
动作 expert:暴露第一帧视觉锚点和完整触觉序列,与控制时使用的 visual-cache 推理模式一致:
因此,非对称 MoT 注意力做三件事:让视觉表示保持稳定、让触觉动力学有视觉上下文、让动作预测同时拿到视觉锚点和接触演化信息。
接触门控的 Action-Visual-Tactile Attention Guidance(AVTAG)
非对称 MoT 注意力虽然允许动作 token 关注触觉 token,但联合训练仍可能更偏视觉。 原因是接触丰富任务里视觉和触觉信号不平衡:视觉在大多数帧上都提供稠密场景信息;触觉形变则局部且时间稀疏,主要在短暂接触区间才有信息,接触之外很弱或几乎不激活。
为此,VT-WAM 引入 AVTAG,见图 2(c)。它加一个仅训练时使用的辅助注意力目标,计算动作 query 对视觉证据和触觉证据的相对注意力。 在接触阶段,用接触门控的 hinge ranking loss(合页排序损失 / 边界排序损失 / 成对合页损失),惩罚“相对触觉注意力低于相对视觉注意力”的情况,从而在局部物理交互有信息时,引导动作 query 提高触觉注意力。
从动作 query 到视觉/触觉 key 构造辅助注意力分布。为简洁省略层号,记动作 query 为 (Q_a),视觉和触觉 key 为 (K_v,K_t)。令 (K_{vt}=[K_v;K_t])。为了引导动作 query、同时不直接改视觉和触觉 key 表示,对 (K_{vt}) 做 stop-gradient(停止梯度):
这个辅助注意力只用于 AVTAG loss:梯度引导动作 query,视觉和触觉 key 仍由主 flow matching 目标优化。 对每个动作 token (r\in{1,\ldots,S_a}),把分给视觉 key 和触觉 key 的辅助注意力分别求和:
再归一化成相对视觉/触觉注意力权重:
AVTAG 只作用于接触阶段的动作 token。记 (C) 为接触阶段动作 token 集合,由显著触觉形变识别。辅助损失为:
这个 hinge ranking loss 只惩罚接触阶段的视觉主导注意力;一旦 (p_t(r)\ge p_v(r)),就不再有惩罚。
训练目标与高效推理
Flow matching 训练目标
VT-WAM 对视觉、触觉、动作 token 做联合 flow matching。三个 expert 各自预测对应模态的速度场:
其中 (\hat{f}_v,\hat{f}_t,\hat{f}_a) 是预测速度场,(f_v\ast,f_t\ast,f_a^\ast) 是对应 flow matching 目标。启用 AVTAG 后,完整训练目标为:
高效的 Visual-Cache 推理
模型支持两种推理模式:
- 联合推理:视觉、触觉、动作 token 一起去噪,用来分析视觉-触觉预测能力
- Visual-cache 推理:用于真机控制。当前视觉观测作为第一帧锚点保留,去掉未来视觉预测。此时只通过非对称 MoT 注意力去噪触觉和动作 latent:触觉 expert 预测未来触觉形变作为接触演化,动作 expert 同时看视觉锚点和触觉序列来预测动作块。这样部署时就不必预测未来视觉 token。
实验
实验设置
- 平台:7-DoF xArm7 + Robotiq 2F-85 夹爪;腕部相机 128×128 RGB,30 Hz;夹爪内侧两枚 Xense 触觉传感器,每路 35×20 的 3D 形变场,30 Hz。
- 数据:每个任务 100 条 人工示教轨迹;视觉 / 触觉 / 本体 / 动作对齐后重采样到 30 Hz。
- 模型:视觉骨干是预训练 Wan2.2-5B;触觉和动作 expert 是约 1B 的 DiT。loss 权重 (\lambda_v=\lambda_t=\lambda_a=1),(\lambda_{\mathrm{AVTAG}}=0.05)。
- 训练:AdamW,lr=1e-4,wd=1e-2,bf16,grad clip 1.0,5% warmup 后 cosine;A100 80GB。
- 推理:远程 A100,动作去噪 10 步。真机控制用 visual-cache(只去噪触觉和动作);预测分析才用联合推理。
- 评测:每方法每任务 20 次独立试验。擦拭/削皮类用 {0, 0.5, 1}(失败 / 完成过半 / 全完成);插入类用 {0, 1}。
实验设计
任务分两类,专门打方法的两个点:视觉看不清局部接触、触觉只在接触阶段有用。
- 表面交互:wipe board、wipe vase、peel cucumber。持续贴着平面 / 曲面 / 可变形表面走,腕部画面变化很小,接触变化在局部。
- 约束插入:insert plug、swipe card、insert tube。要精细对准;insert tube 还透明,视觉更不可靠。
基线按「怎么用触觉 / 要不要世界模型」分层:
- DP+Tactile:触觉当条件,直接预测动作
- RDP:触觉做在线修正
- (\pi_{0.5}):纯 VLA,无触觉
- OmniVTLA:VLA + 触觉输入
- Fast-WAM:视觉世界动作模型,无触觉
共同设定:同一批示教、同一机器人、同一任务定义、同一指标,每个任务单独训。
消融只做 wipe vase 和 insert tube,对应两类任务,拆两问:
- 触觉动力学怎么接到动作上?对称 MoT、只看第一帧触觉、看完整触觉序列。
- AVTAG 有没有用?同样的非对称 MoT,只加不加接触门控引导。
实验效果
主结果:
| 方法 | 擦板 | 擦花瓶 | 削黄瓜 | 表面均 | 插插头 | 刷卡 | 插管 | 插入均 | 总均 |
|---|---|---|---|---|---|---|---|---|---|
| DP+Tactile | 30 | 20 | 25 | 25.00 | 5 | 35 | 15 | 18.33 | 21.67 |
| RDP | 45 | 60 | 40 | 48.33 | 15 | 35 | 10 | 20.00 | 34.17 |
| (\pi_) | 40 | 35 | 35 | 36.67 | 30 | 45 | 10 | 28.33 | 32.50 |
| OmniVTLA | 45 | 30 | 25 | 33.33 | 40 | 35 | 40 | 38.33 | 35.83 |
| Fast-WAM | 70 | 55 | 45 | 56.67 | 20 | 55 | 25 | 33.33 | 45.00 |
| VT-WAM | 90 | 85 | 70 | 81.67 | 60 | 70 | 55 | 61.67 | 71.67 |
- 总均** 71.67%**,比最强基线 Fast-WAM 高 26.67,比 OmniVTLA 高 35.84。
- 触觉当输入不够。 表面任务上 OmniVTLA(33.33%)甚至低于 (\pi_{0.5})(36.67%)。作者解释:只把触觉当 policy input,学不到接触动力学。
- 视觉动力学有用,但不够。 Fast-WAM 把表面任务拉到 56.67%,说明 action-conditioned 世界模型有效;可它仍是视觉-only,局部接触抓不住。
- 把触觉形变当动力学来预测,才是关键。 VT-WAM 表面 81.67%、插入 61.67%。透明管插入提升最能说明问题:视觉对准不可靠时,必须靠接触修正。
触觉预测质量(Table II,越低越好 / cosine 越高越好):
- exUMI:(l_2=0.091),cos=0.618
- UVA:(l_2=0.083),cos=0.667
- VT-WAM:(l_2=0.077),cos=0.749 说明触觉 expert 学到的是有方向、有接触迁移的形变,不只是动作拟合附带出来的。
消融:
| 变体 | 设计 | 擦花瓶 | 插管 |
|---|---|---|---|
| M0 Fast-WAM | 只有视觉动力学 | 55 | 25 |
| M1 + 对称 MoT(完整触觉序列) | 加触觉,但推理还要预测未来视觉 | 65 | 40 |
| M2 + 非对称 MoT(只看第一帧触觉) | 有触觉,但没有时序 | 40 | 30 |
| M3 + 非对称 MoT(完整触觉序列) | 第一帧视觉锚点 + 完整触觉 | 70 | 50 |
| M4 VT-WAM = M3 + AVTAG | 再加接触门控引导 | 85 | 55 |
- 加触觉序列有收益(M0→M1),但对称融合推理贵。
- 必须看触觉时序,不能只看第一帧。 M2 擦花瓶掉到 40%,比纯视觉 M0 还差。
- AVTAG 在擦花瓶上 70→85,插管 50→55。花瓶扰动实验更直观:支撑面下移导致失接触后,腕部画面几乎不变;没 AVTAG 时动作 expert 一直盯视觉,回不了接触;有 AVTAG 才会在接触阶段提高 (p_t),重新贴上并完成任务。
总结
提出 VT-WAM,一个面向接触丰富操作的视觉-触觉世界动作模型。它把世界动作模型往前推了一步:把触觉形变当作时序交互动力学,和动作预测一起学,而不是只把触觉观测当作策略的辅助输入。
把触觉形变建模成交互动力学,是提升接触丰富任务动作预测的有效途径。
局限性
现在是 单任务特化,每个任务单独训,为的是把触觉建模做准。 没有 multi-task,也没有规模法则实验。 因此还不能当成通用视觉-触觉策略,只能当成「接触丰富任务上,WAM 该怎么接触觉」的方法验证。
泛化范围窄。 6 个任务、同一台 xArm7 + Xense、每任务 100 条示教、每项 20 trial。没有跨物体、跨机器人、跨任务的硬测试。
「加触觉」这件事本身没有被公平打满。 OmniVTLA 把触觉当输入甚至变差,只能说明「当输入不够」,不能说明所有触觉融合都弱;更强的 reactive / 力控基线也没有按同样世界模型尺度对齐。
AVTAG 不是万能模块。 擦花瓶 70→85,插管只有 50→55。它依赖「明显触觉形变」来标接触阶段;接触弱、传感器噪声大、或任务更靠几何对准时,收益会缩。
非对称读出是速度换信息。 部署时动作只看第一帧视觉 + 触觉序列,丢掉未来视觉。接触任务吃得开,但需要视觉前瞻的任务未必适用。消融里只看第一帧触觉(M2)还会掉点,说明这套设计对「必须看到时序触觉」很敏感。
训练和部署不是同一条前向。 预测可视化走联合推理,真机控制走 visual-cache。图 5 证明「能预测接触」,不直接等于「部署时的动作头看到了同样的未来」。
指标会让表面任务更好看。 擦拭/削皮是 {0, 0.5, 1},插入是 {0, 1}。平均成功率 71.67% 里,表面 81.67% 贡献更大,不能直接理解成插入也一样稳。
工程代价没报。 视觉 Wan2.2-5B + 两个 1B DiT,没给延迟、显存、相对 Fast-WAM 的额外开销。visual-cache 只是省了未来视觉去噪,不是轻量模型。