Not All Actions Are Equal: Rethinking Conditioning for Dexterous World Model
Not All Actions Are Equal: Rethinking Conditioning for Dexterous World Model
一句话总结
DexAC-WM 要解决的是:高自由度灵巧动作各维尺度差太大。如果用最朴素的做法,把所有动作压成一个总向量再注入,手指这种很小的运动会被手腕和头部的大运动淹没,动作语义就塌掉了。方法分成两块。 第一块:动作怎么注入(DexAC)
- SAT(结构化动作分词):每个动作维度先单独归一化,再单独做成 token。手指关节、双手腕的相对位姿、头部/相机运动先分开,不混在一起。
- 局部支路:用视频隐变量当提问(Q),动作用 token 当键值(K/V),做交叉注意力。这样模型能把细微手指动作对到画面里的手。
- 全局支路:用可学习查询把全部动作 token 汇总成一个整体运动意图,再通过自适应层归一化,调节每一个 DiT 层。这管的是手腕、相机、整段动作是否连贯,不是只看某一根手指。 第二块:画面懂什么(语义支路)
- DINOv3 提供视觉物体/场景信息,VLM 提供文本信息。
- 它们分别和视频隐变量做交叉注意力,再加起来,让模型知道「看见的是什么」,而不只是手怎么动。 一句话:局部管细、全局管整、语义管看见什么。 三块一起,才同时提高画面质量和动作跟随。
引言
动作条件世界模型最近在复杂交互建模、以及按不同动作序列预测未来状态方面进展不错。这些模型往往靠更强的视觉表征和更大容量往前推,动作条件本身却一直被低估。 高自由度灵巧动作本身是异构的,量级能差好几个数量级——大尺度运动和细微但关键的信号同时存在。
提出 DexAC-WM:把动作条件当成结构化过程,而不是全局压缩。用动作 tokenization(分词) 保留维度级语义,再用局部 refinement(细化) 和全局 modulation(调制) 把动作信号对齐到视觉动态。
针对现有世界模型高层语义 grounding 不足,我们再加一条语义分支,提供丰富的物体–场景先验,让模型既能抓住动态视觉细节,又能做高自由度动作条件视频预测 Grounding是指将自然语言与真实世界的实体或概念联系起来的过程。通过grounding,模型可以将语言中的词语或句子与实际世界中的对象、场景或操作相对应。例如,对于句子“我要吃一个苹果”,grounding可以将“苹果”与真实世界中的苹果对象相关联。
结论是:要把世界模型扩到高自由度控制,既需要结构化动作建模,也需要语义 grounding。
项目页:https://zizhaoyuan.github.io/DexAC-WM
引言
要达到人类级灵巧,就必须充分利用第一人称数据,让世界模型从第一人称出发内在理解动作空间。 动作条件生成是学习交互式世界动态的一条靠谱路线。
第一人称视频里,手腕/相机这类全局运动会在尺度上占主导,手指关节却极细、却语义关键。这种不平衡会带来梯度主导效应:高方差维度过度影响优化,把低量级信号压下去。
如何结构化表示细微手部动作特别难,主要卡在三点:
- 高自由度灵巧动作的异构性与细微性。 核心问题是:动作条件该如何结构化表示,才能缓解复杂第一人称世界模型里灵巧手的异构语义塌缩?
- 全局压缩式动作条件的局限。 现有工作大致三类灵巧动作表示:一是关节空间,把重定向后的高自由度关节值直接当动作输入;二是几何关键点/指尖表示,从人类视频里更好抽;三是网格驱动的隐式条件,用渲染手网格或人体姿态引导视频生成。这些方向有启发:手部监督和关键点动作对灵巧世界建模很重要;第一人称手部运动序列加上场景渲染能驱动合理交互生成;关节空间和指尖空间在人到机器人迁移上各有取舍。但这些条件策略往往把整个动作向量压成一个 embedding,异构语义必然塌掉,动作跟随变差,物理预测也不稳。我们认为:这种聚合在高自由度区间会从根本上失效。
- 语义 grounding 不足。 除了动作条件本身,近期 2D/3D 表征编码器和基础模型在视觉生成与空间理解上潜力很大。也有工作把预训练视觉/几何特征当额外预测状态。但多数动作条件世界基础模型仍只靠一个 VLM reasoner 提供有限语义。这些语义和几何先验在第一人称灵巧世界模型里几乎没被用起来,而高自由度手部运动恰恰需要细粒度的动作–空间对齐。
提出 DexAC-WM:一个第一人称动作条件世界模型,专门重思考高自由度灵巧控制下动作该如何表示、如何注入。核心观点是:动作维度在整个条件过程中应保持结构化,而不是塌成一个表征。
引入 结构化动作表示:把高自由度动作拆成语义独立、并做量级对齐的 token,让异构运动因素能均衡学习。
再提出 统一局部–全局条件模块,把动作注入拆成两条互补通路:局部 refinement 用 cross-attention 注入细粒度动作 token,把细微运动对齐到局部视觉动态;全局 modulation 汇总动作意图,用自适应调制注入,保证时序连贯。
再引入 语义条件:把 DINOv3 特征与 VLM 文本 embedding 用 cross-addition 融合注入。
结构化动作表示 + 语义条件,是把世界模型扩到高自由度控制的关键,也为具身生成系统中的动作建模提供了新视角。
贡献如下:
- 指出现有动作条件世界模型在高自由度灵巧设定下的核心缺陷:全局动作聚合会因异构维度的尺度失衡,把细微但语义关键的手指信号压掉。
- 提出 DexAC:面向高自由度灵巧世界模型的结构化动作条件模块。它用 tokenization 保留维度级动作语义,再用统一局部–全局条件机制把异构动作重新耦合,同时实现细粒度和全局连贯运动。
- 引入带 DINOv3 的 语义条件分支,为视觉–时序预测提供强语义先验;DexAC 再把这些先验对齐,进一步提升动作跟随一致性。
- 在 EgoDex 和 EgoVerse 上,DexAC + 语义条件相对 Wan、IRASim、Cosmos 等先进基线,FID、FVD、PCK 都有明显提升。IRASim 上的结果进一步说明结构化动作条件可扩展。
案例分析
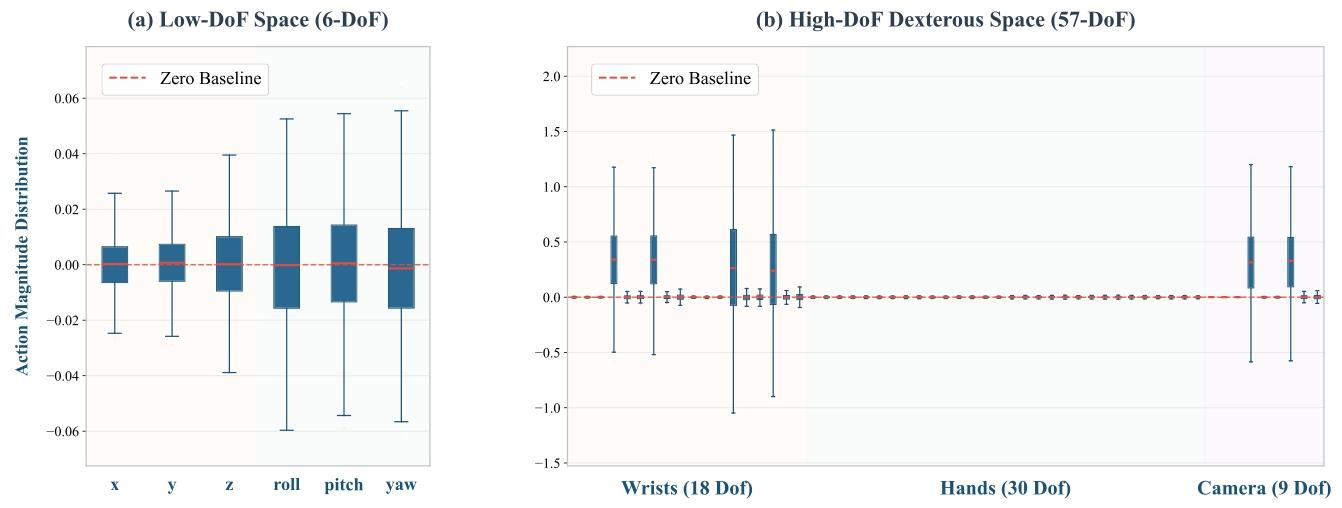 图 2. 动作幅度分布的经验比较。(a) 低自由度动作空间(6 自由度)。平移和旋转维度保持有界方差,处于 (10^{-2}) 量级,有效避免了梯度支配。(b) 高自由度灵巧动作空间(57 自由度)。宏观运动(手腕/相机)与微观运动(手指)之间存在严重的 (10^5) 量级尺度差距,造成了关键优化瓶颈。注意,由于手指关节(30 自由度)处于 (10^{-5}) 量级,相比于 (10^\circ) 的宏观运动,其分布几乎呈平坦状。
高自由度灵巧动作不是低自由度动作简单加维,而是同时包含数值尺度、语义角色都差很多的异构运动因素。这种尺度异构会直接打乱朴素全局动作注入的优化过程。
在标准 MLP 动作编码器里,所有动作维度先被投影成一个共享 embedding,再和视觉特征交互。过程中,手腕、头部这些大量级维度会主导共享动作表征,低量级手指维度很容易被全局运动压掉。结果就是:模型对异构动作尺度不敏感,也抓不住细微动作带来的视觉变化。
动作缩放 / 逐维归一化能缓解原始数值失衡,但解决不了全局聚合带来的表征塌缩。就算缩放过了,普通 MLP 仍会把腕姿、手指关节、自我运动压进同一个 embedding,在视觉–动作对齐之前就把语义不同的运动因素混在一起。所以:
尺度对齐是必要的,但对高自由度灵巧条件来说还不够。
方法
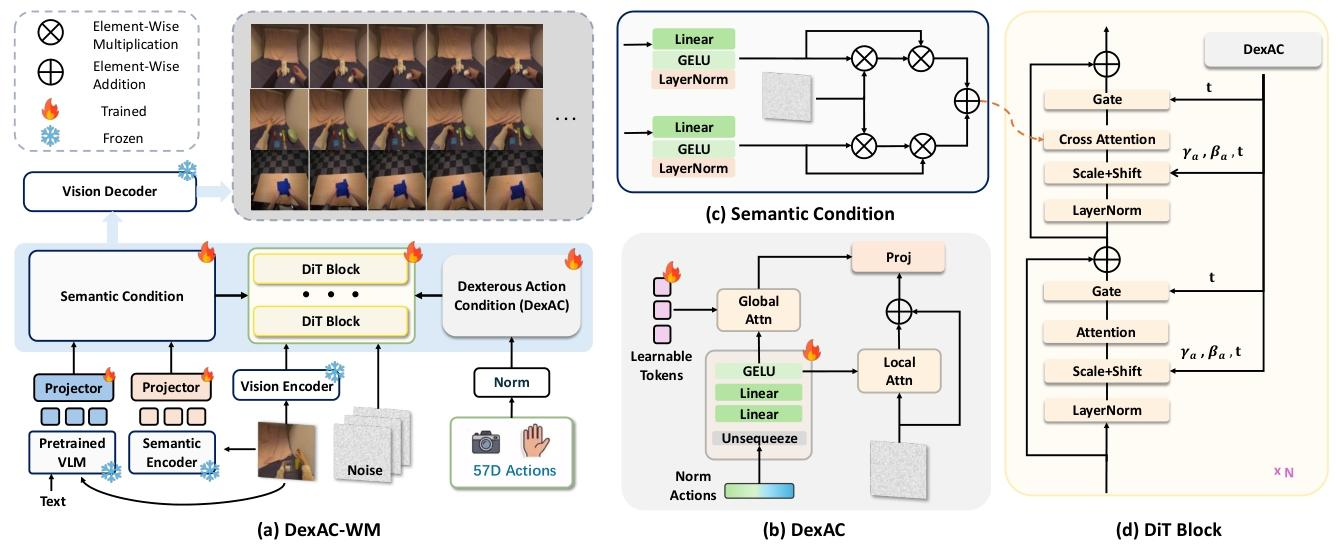 图 4. DexAC-WM 架构图。DexAC 旨在显式捕捉高自由度动作场景中精确的局部灵巧性与全局连贯运动,而语义条件则提供丰富的基于场景和物体的表示,用于语义理解。(b)展示了 DexAC 的结构,用于保留维度级结构化动作,并通过局部和全局注意力细化实现自适应动作注入。(c)引入两个普通交叉注意力,将 DINOv3 特征与 VLM 语言嵌入结合,以进行最终相加。(d)展示了 DiT 主干架构,总共 28 个块,来自 DexAC 的结构化动作表示通过自适应层归一化 (AdaLN) 注入每个块。
核心想法:动作条件不是一次全局压缩,而是和视觉感知一起优化的结构化过程。
预备知识
问题定义
给定初始观测 (I_0) 和动作序列,预测未来视觉序列:
其中 (\hat{V}_{1:T}={\hat{I}_1,\dots,\hat{I}_T}),(\hat{I}t\in\mathbb{R}^{H\times W\times 3}),(D_a=57),(T) 是动作 horizon(动作序列长度、预测时域)。逐步看时,把每帧 (I_t) 当视觉状态 (S_t),(A_t) 是 (S_t\to S) 之间的动作:
相对常见 6-DoF 夹爪设定,这里是 57 维灵巧动作,视觉动态更复杂,所以需要更结构化的条件机制。
训练目标
用 rectified flow(匹配流的一种) 的速度预测:
其中 (x_{\tau}=(1-\tau)S_{t+1}+\tau\epsilon),(\tau\in[0,1]),(\epsilon\sim\mathcal{N}(0,I)),目标速度 (v=\epsilon-S_{t+1})。条件 (c={c_v(S_t),c_a(A_t)}):(c_v) 来自当前视觉状态,(c_a) 来自动作的逐维 tokenization + 统一局部–全局条件。(u(\cdot;\theta)) 是速度预测网络。
Rectified flow 它把噪声 (\epsilon) 和数据 (S_{t+1}) 用直线连起来:
直线上速度是常数:
中间点是线性插值,网络只学一个不变方向。名字里的 rectified,就是把弯轨迹「拉直」。还可以再 reflow:用已经训好的模型造 ((\epsilon, \hat{S})) 对,再训一轮,轨迹更直,采样步数更少。
总览
backbone(骨干) 是 Cosmos-Predict2.5。文本条件用 Cosmos-Reason1,多层 Transformer 聚成 2048 维。视觉条件:每帧 RGB 过冻结的 Wan2.1 encoder。
动作模块三块:
- 结构化动作表示。 不把动作压成一个 embedding,而是用 SAT(Structured Action Tokenizer) 做出逐维 token,保留时间演化和各运动因素的语义独立性。
- 统一局部–全局条件。 局部支路注入细粒度动作 token,抓微动;全局支路用可学习 query 汇总动作 token,给序列级连贯引导。
- 双 Cross-Attention 语义条件。 DINOv3 特征和文本 embedding 一起注入 latent:latent token 当 query,多模态特征当 key/value。几何和意图一起推理,提升时空一致性。
DINOv3 是冻结的「看图编码器」,给世界模型提供和像素对齐的几何先验。DINOv3 是 Meta 2025 年发的自监督视觉基础模型,把一张图切成很多 patch,给每个位置吐一个特征向量。不靠人工标注,也能学到「这是手、这是杯子、空间上怎么摆」这类信息。 CLIP 一类是图文对齐,强项是分类、检索、全局语义。DINOv3 是纯视觉自监督,强项是稠密空间特征。这篇要跟手部微动、物体接触,所以选 DINO,不选 CLIP。
结构化动作表示
为在第一人称观测下建模高自由度灵巧操作,SAT 显式刻画双手腕相对运动、手指关节、头部 ego-motion。
动作表示
相邻时刻手位姿 (T_t,T_{t+1}\in SE(3)),相对变换 (T_t^{-1}T_{t+1}),得到相对平移 (R_t^\top(p_{t+1}-p_t)) 和相对旋转 (R_t^\top R_{t+1})。为避开欧拉角,旋转用连续 6D 表示。最终动作向量包括:
- 双手腕相对运动(平移 + 旋转)
- 手指关节位移(精细屈伸)
- 头部旋转变化(相机 ego-motion) 这套统一高自由度表示同时建模大手运动、局部手指、视角变化。相对相机系位移,它把手运动和视角变化解耦,学习更稳,动作条件预测也更物理一致。
动作不要写在相机坐标系里,而要写成手自己坐标系下的相对刚体运动 DexWM、EgoDex 默认 benchmark 常把手关键点直接写在 当前相机坐标系。问题是:头一转,相机系跟着转,手其实没动,xyz 也会变。模型会把「转头」和「伸手」搅在一起。 这段的解耦就是:
- 手腕相对运动:手相对自己上一时刻怎么动
- 手指关节位移:手指怎么屈伸
- 头部相对运动:相机自己怎么动 世界模型看动作时就能分开想:这是手在抓,还是头在转
SAT(Structured Action Tokenizer)
(B)(batch):一次训练塞进去多少条样本。比如 (B=8),就是 8 段第一人称片段一起算。 (T)(time / horizon):每条样本覆盖多少个动作时刻。世界模型通常一次看一个 chunk,比如 (T=8) 或 (T=16),不是整段视频从头到尾。 (D_a)(action dimension):每个时刻的动作维数。这篇里 (D_a=57):两只手腕、手指关节、头部/相机相对运动拼在一起。
灵巧动作异构,手指/手腕尺度和分布都不同。先对每个维度独立归一化。动作序列 (a\in\mathbb{R}^{T\times D_a}),训练集上第 (i) 维均值 (\mu_i)、标准差 (\sigma_i):
形状 ((B,T,D_a)) 的动作先不 flatten(拉平),如果经过一个MLP后就将维度叠在一起了,不好拆分了。每个动作分量独立投影到 token 空间:
再沿时间做可学习融合,把每维动态收成一个 token,形状 ((B,N,C)),(N) 等于动作维数,(C) 是每个动作 token 的通道数:
每个 token 总结第 (i) 维的时间演化。相对普通 MLP 把整段动作压成一个全局向量,这里保住了维度级语义,更适合细粒度动作条件。
| 普通 MLP | SAT | |
|---|---|---|
| 输入处理 | (T\times 57) 拉平 | 每维单独走 |
| 输出 | 1 个向量 | 57 个 token |
| 手指微动 | 被手腕大运动平均掉 | 自己占一个 token |
| 后续怎么用 | 只能整体调制 | 视觉 token 可以只 attend 到相关动作维 |
SAT = 逐维标准化 + 逐维升维 + 逐维时间汇总。输出 57 个动作 token,而不是 1 个动作向量。
统一局部–全局条件
要把高自由度动作注入视频 backbone,提出 Unified Local-Global Conditioning:局部 refinement + 全局 modulation。
- 局部 refinement:用细粒度动作 token 直接调 latent noise
- 全局 modulation:汇总整体动作意图,经自适应特征调制注入 DiT
局部动作 refinement
原始动作数值很小,tokenization 前先乘常数缩放,加强条件、稳住优化。再投影进 diffusion backbone 的 latent 空间。噪声 token (Z\in\mathbb{R}^{N\times d}),局部注入:
每个 latent token 主动 query 结构化动作,细粒度动作能直接 refine 噪声分布。残差连接保住原 latent 结构。
全局动作 modulation
局部 attention 是 token-wise(逐token、以每个 token 为单位来算) 的,缺显式全局结构,跨帧运动趋势不好保,高自由度下时序/结构依赖又很强。于是加可学习全局 query (q_g\in\mathbb{R}^{1\times d}):
(A_g\in\mathbb{R}^{1\times d}) 是当前动作 chunk 的整体运动意图。再变成 scale(缩放)/shift(平移):
用 AdaLN(自适应层归一化) 调制局部 refine 后的特征:
这样局部动作条件特征再对齐全局动作上下文,序列级动态更一致,DiT(Diffusion Transformer) 也拿到更强全局控制。
自适应动作注入
每个 DiT block 里把两路合进 AdaLN:局部 cross-attention 让噪声 token 直接感知结构化动作(细粒度跟随);全局支路把动作收成紧凑向量再 AdaLN 注入(整体运动连贯、物理一致):
相对「一个 embedding 注入」,这里不提前平均所有维度,保住维度结构,强调细微但语义关键的信号,局部 refine 和全局 modulation 互补。生成时既能抓精细灵巧细节,也能抓长程运动一致性。
双 Cross-Attention 语义条件
ViT(vision transformer) 给高层语义,DINO 给和图像对齐的稠密空间表征,加强手–物区域定位和场景几何推理
用 dual cross-attention(双路交叉注意力) 把 DINOv3-L 视觉特征和文本 embedding 一起注入 latent:latent token 当 query,DINO token 和文本 embedding 当 key/value。DINO 给稠密、图像对齐的空间线索(物体几何、场景结构);文本给紧凑全局语义(高层意图)。 为平衡两模态,把 DINO token 和文本 token 在序列维拼接,再 cross-attention 聚合。模型就能同时用空间细节和语义线索推理,未来外观和运动的时空一致性都更好。
实验
实验设置
数据- EgoDex:829h、1080p、30Hz;194 个操作任务、500 物体;上肢 3D 骨架 + 每手 25 关键点。用全量 train/test。
- EgoVerse:1362h、80k episodes、1965 任务、240 场景。用 EgoVerse-A。
动作输入:57-DoF- 手指:每手 15 维,共 30
- 手腕:每腕 9 维(平移 3 + 6D 旋转 6),共 18
- 相机相对位姿:9 维
训练- 8×H200,batch 64
- 滑窗:30 帧非重叠窗,每窗随机 2 个起点,切成 13 帧 clip(1 条件帧 + 12 步预测)
- backbone:Cosmos-Predict2.5-2B
- 目标:rectified flow 的 MSE 速度预测
- AdamW,lr=4e-5,wd=0.1
评测- 协议对齐 Cosmos-Predict2.5-DROID:12 帧 chunk,再重采样成 26 帧 / 30fps
- 分辨率 224×224
- 画质:PSNR / SSIM / LPIPS
- 生成质量:FID / FVD(Cosmos-Cookbook)
- 动作跟随:PCK@10(更严)、PCK@20(整体运动对不对)
基线- Wan2.1 / Wan2.2 Control
- IRASim
- Cosmos-Predict2.5-2B
实验设计
| 主张 | 怎么验 |
|---|---|
| 全局压缩不够 | Cosmos / IRASim 的 vanilla MLP 条件 vs DexAC |
| 局部+全局都要 | 去掉 Local Attn / Global Attn |
| 细微维度真的被用上了 | AdaLN heatmap;wrist / finger / head 三组 PCK |
| 归一化不够,还要结构化 | 去掉 per-dim norm;全维 ×200 |
| 语义 grounding 必要 | +DINOv3、DexAC、两者一起 |
| 可迁移 | IRASim + DexAC |
| 长程还行不行 | 65 帧(>2s)rollout |
实验结果
EgoDex
| 模型 | FID↓ | FVD↓ | PCK@10↑ | PCK@20↑ |
|---|---|---|---|---|
| Wan2.1 | 194 | 1532 | 20.4 | 36.9 |
| IRASim | 154 | 615 | 27.8 | 44.8 |
| IRASim+DexAC | 143 | 565 | 33.9 | 51.4 |
| Cosmos Base | 115 | 352 | 31.1 | 58.3 |
| +DINOv3 | 110 | 978 | 33.9 | 60.8 |
| +DexAC | 114 | 349 | 34.2 | 61.4 |
| Ours | 107 | 284 | 32.7 | 60.6 |
EgoVerse
| 模型 | FID↓ | FVD↓ | PCK@10↑ | PCK@20↑ |
|---|---|---|---|---|
| IRASim | 230 | 989 | 41.7 | 57.9 |
| IRASim+DexAC | 225 | 963 | 44.7 | 58.1 |
| Cosmos Base | 152 | 956 | 24.6 | 41.2 |
| +DINOv3 | 162 | 858 | 26.5 | 41.7 |
| +DexAC | 152 | 920 | 24.2 | 42.7 |
| Ours | 140 | 830 | 40.6 | 60.5 |
定性
Base:场景能糊出来,手形容易歪,手–物对不齐。 遮挡时 Base / +DexAC 容易把物体“吃掉”。 +DINO:物体/场景语义更好,但动作会漂。 +DexAC:手部结构和轨迹更稳,物体交互一般。 Full:手姿、轨迹、交互一起更好,累积漂移更小。 难点仍在:叠衣服这类可变形物体、多物体交互。
消融
局部 vs 全局:
| 配置 | FID | FVD | PCK@10 | PCK@20 |
|---|---|---|---|---|
| MLP embed | 115 | 352 | 31.1 | 58.3 |
| w/o Local | 115 | 377 | 30.5 | 58.5 |
| w/o Global | 116 | 420 | 30.8 | 54.2 |
| Full DexAC | 107 | 284 | 32.7 | 60.6 |
| 去掉 Global 掉得最狠:全局意图负责稳住时序。 | ||||
| 去掉 Local:FVD/PCK 变差,细动作跟丢。 | ||||
| 结论:局部 refinement 抓手指,全局 modulation 抓手腕/相机大趋势,缺一不可。 |
细维度有没有被用上:
- MLP:少数通道主导,细动作被压。
- 去掉 Global:激活散、不稳。
- DexAC:通道更均衡。
- DexAC+DINO:更集中、更像语义对齐。
- 结论:结构化条件让小量级维度真的进表征了,不是只做了归一化。
三组动作谁受益:
| 方法 | Wrist PCK@10 | Finger PCK@10 | Head PCK@10 |
|---|---|---|---|
| MLP | 7.0 | 7.0 | 3.9 |
| w/o Global | 88.8 | 0 | 0 |
| w/o Local | 48.9 | 29.0 | 35.8 |
| DexAC | 33.0 | 33.0 | 40.0 |
| Ours | 54.7 | 29.7 | 41.2 |
| MLP 三组都弱。 | |||
| 去掉 Global 会塌成只跟手腕,手指/头全 0。这正好对应方法里的“梯度主导”。 | |||
| DexAC 把三组拉平。 | |||
| +DINO 后再加强手腕/头,平均最好。 |
归一化 vs 结构化:
- 去掉 per-dim norm:FVD 418(Full 是 284)
- 全维 ×200:FVD 371,仍明显差
- 结论:尺度对齐必要,但不充分。不 tokenization,语义还是会塌
语义注入强度 / 长程:
- DINO 注入权重变一点,结果波动不大;缺语义比权重更致命。
- 65 帧长程(Table 5):Full 仍最好(FVD 465 vs Base 525),但 PCK 明显掉(约 27/51)。短程有效,长程误差累积还在。
总结
- 高自由度失败点不是“维数多”,是异构尺度 + 全局压缩。手腕/相机淹没手指。
- DexAC 的有效配方:
- 逐维 normalize + tokenize(保住维度语义)
- Local Attn(细动作)
- Global AdaLN(整体意图/时序)
- 语义分支(DINOv3)补的是物体/场景,不是动作本身;单加会伤时序,必须和 DexAC 一起。
- 模块可插:IRASim 上也涨,说明贡献在 conditioning interface,不在换更大 backbone。
- 还没解决:长程 rollout、可变形物体、遮挡后的物体保持。
一句话:高自由度世界模型,先别把动作压成一个向量;结构化动作条件 + 语义 grounding,比单纯加大模型和加视觉先验更对症。
总结
提出 DexAC-WM:一种面向高自由度灵巧世界模型的结构化动作条件方法,保留动作各维度的语义,并通过局部精修(local refinement)与全局调制(global modulation)把异质动作重新耦合起来。 引入额外的语义条件 grounding,持续提升 DexAC-WM 的视觉–时间质量与动作一致性
高自由度世界模型不能只靠把动作压成一个全局向量,而要同时做 结构化动作条件 和 语义 grounding。
局限性
视角受限:当前框架基本只吃第一人称观察。Egocentric 对 embodiment 很强,但缺少多视角空间信息,不利于迁到人形机器人或其他更复杂 embodied agent。
规模与时长都还短:受算力限制,模型尺度固定,预测 horizon 也较短。还没系统验证:更大模型、更长生成、以及 VGGT 这类几何先验会不会改变结论。65 帧(>2s)时 FVD/PCK 已经明显掉:Full 仍最好(FVD 465 vs Base 525),但 PCK@10/@20 大约只剩 27/51。
训练贵:仍依赖监督微调(supervised finetuning),计算成本高。后续想走更轻量的 adaptation。
两类硬失败:- 长程误差累积 → 宏观运动漂移 / long-horizon 偏离。单独 DexAC 对手部局部结构更好,但长时间仍会 drift;完整模型更稳,但没根治。
- 自遮挡或复杂操作 → 看不见的几何导致手指细节变形。遮挡歧义与长程漂移仍是未来工作。