DeCAL_ Towards Physically-Grounded Dexterous Vision-Language-Action Models via Contact-Aware Latent Co-Imagination
DeCAL_ Towards Physically-Grounded Dexterous Vision-Language-Action Models via Contact-Aware Latent Co-Imagination
一句话总结
DeCAL 使用三专家 MoT 架构。理解专家基于 Qwen3-VL 处理语言与多视角视觉,并通过 cross-attention 引入多指触觉 token;触觉融合采用残差方式,同时由全局触觉 token 生成接触感知门控权重,自适应控制触觉对策略的影响。生成专家在 latent space 中联合预测未来视觉与触觉动力学,其中视觉预测采用非自回归 parallel decoding 以满足实时控制需求。动作专家使用 Factorized Flow Matching,将机械臂与灵巧手动作分别加噪和投影,但在 Transformer 中联合建模,并基于语义理解、未来视觉-触觉 latent 和机器人状态生成动作块。
摘要与引言
灵巧操作涉及与物理世界进行接触丰富且精细的交互,这给现有视觉-语言-动作(VLA)模型带来了巨大挑战,因为严重的视觉遮挡和复杂的接触动力学难以处理。
DeCAL:一个面向接触丰富灵巧操作的物理基础型 VLA 模型,统一了理解、想象与动作生成,基于混合专家 Transformer 架构,为不同能力配备专门专家,同时保证高效信息交互。
提出自适应视觉-触觉融合,通过“接触感知门控”动态调节触觉交互。 提出“视觉-触觉潜空间联合想象”,共同建模视觉与触觉动力学,使策略隐式掌握物理世界知识。
触觉反馈能够直接提供接触状态、力变化、滑移和物体形变等物理交互信号,对灵巧操作至关重要。
首先,DeCAL 基于混合专家 Transformer 架构,由“理解、想象、动作生成”三个协同专家组成,并通过联合注意力实现定向知识共享,为连贯、精细的灵巧操作提供隐式引导。其次,我们引入自适应视觉-触觉融合机制,利用接触感知门控动态注入触觉信息,使模型在物理交互中能有选择地加强触觉线索。最后,我们提出“视觉-触觉潜空间联合想象”,通过面向未来的潜空间想象联合建模视觉-触觉动力学,为策略注入隐式世界知识
- 我们提出 DeCAL,一个灵巧的视觉-触觉-语言-动作框架,它统一了理解、生成与动作,以实现有效的视触觉表征学习。
- 我们引入自适应视触觉融合与视触觉潜在协同想象,以促进接触丰富且精细的灵巧操作。
- 我们通过一系列真实世界实验证明了该方法的有效性与泛化能力。
机器人设置
由一对 6 自由度(6-DoF)UR5 机械臂和两只 22 自由度的 SharpaWave 五指灵巧手组成。视觉观测由两台腕部相机和一台头戴式第一人称相机采集,全部使用 Intel RealSense D435。每个指尖都配备了 Sharpa 开发的高分辨率(320 × 240)视觉触觉传感器,从而能在操作过程中对接触动力学进行细粒度感知。具体而言,传感器内部的摄像头会捕捉物理交互时弹性表面的形变。基于原始触觉图像和视觉-触觉处理算法,我们将触觉信号表示为以下三种互补形式:
- 原始图像(R):直接由每个视觉-触觉传感器内部的摄像头采集的原始触觉观测,用于记录接触模式与弹性表面形变。
- 合力(F):每个指尖输出 6-DoF 力表示,包含三轴力和力矩。该力信号通过一个预训练回归模型从原始触觉观测估计得到,实现带力感知的触觉感知。
- 形变图(M):每个指尖通过一个转换模型输出形变深度图,表示为 2D 图像,其中每个像素指示触觉表面的局部形变深度,提供细粒度几何接触信息。
方法
预备知识
策略目标是根据多模态观测预测一个动作片段。大多数现有 VLA 模型缺乏对未来交互动力学的显式建模,因此难以推理细粒度物理交互。 提出统一 VLA 框架 DeCAL (\pi_\theta),它能联合执行场景理解、物理想象和动作生成。给定当前观测 (o_t=(I_t,H_t,s_t)) 和语言指令 (l),其中 (I_t) 表示视觉观测,(H_t) 表示触觉观测,(s_t) 表示机器人状态。DeCAL 被训练为联合最大化未来视觉-触觉潜在表示 (z_{t+H}) 和未来动作 (a_{t+1:t+H}) 的似然:
模型架构
DeCAL 采用 Mixture-of-Transformers(MOT)架构,在统一框架中无缝整合场景理解、视觉-触觉动力学前瞻以及动作生成。如图 2 所示,该框架由三个专用 Transformer 专家组成。
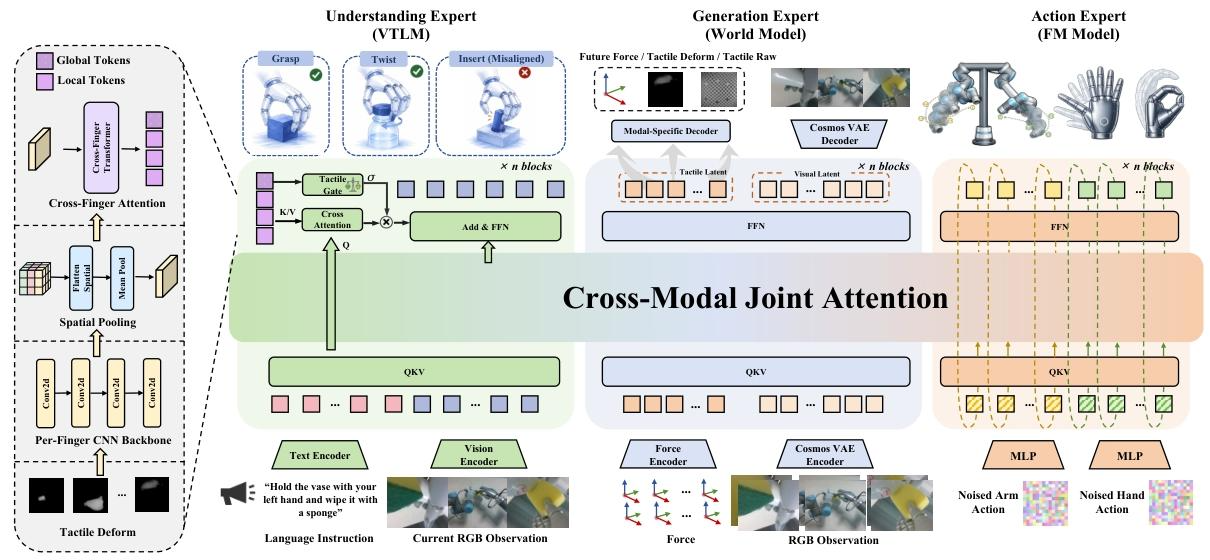 图2:DeCAL 基于 MoT 架构构建,该架构统一了场景理解、视触觉动态预测与动作生成。Action Expert 采用因子化流匹配(Factorized Flow Matching)来解耦手臂与手部运动,从而实现更好的协调性与灵巧操作。
理解专家
基于 Qwen3-VL 构建,以利用其强大的多模态理解能力
给定语言指令和多视角视觉观测,模型先将输入编码为文本 token 和视觉 token,再通过 Transformer 块处理,生成上下文嵌入,并通过掩码自注意力机制与下游专家共享。
通过专门的跨注意力机制,把多模态输入扩展到触觉观测:触觉特征作为键和值,视觉-语言特征作为查询。所得表征随后通过残差方式与自注意力特征融合,使模型能够在统一潜在空间中对视觉、语言和触觉观测进行联合推理。
生成专家
通过根据历史交互预测未来视觉与触觉观测,显式建模视觉-触觉动力学,形成具有物理依据的多模态世界表征,以引导下游动作生成。
采用并行解码策略生成未来视觉-触觉信息。这种非自回归范式显著提高计算效率,同时对建模未来视觉-触觉交互仍然有效。
尽管近年视频生成模型在视觉预测方面进展显著,但直接将生成式建模用于接触丰富的操作任务仍然困难,因为高频机器人控制对实时性要求严格。
DeCAL 的生成专家会根据历史交互预测未来视觉和触觉表征。 输入包括:
- 历史视觉帧
- 当前视觉观测
- 当前触觉力
- 语言指令
- 理解专家产生的上下文表征
输出包括:
- 未来视觉 latent
- 未来触觉 latent
对于视觉部分,DeCAL 先用 Cosmos VAE tokenizer 把图像编码成 latent,然后用 token 压缩机制把 (32\times32) 的 latent grid 下采样到 (4\times4),减少序列长度。之后,压缩后的 token 被并行解码,用来生成未来视觉帧。
非自回归方法的一个常见问题是:如果未来单元之间有很强的时序依赖,完全并行生成可能会丢掉细粒度因果结构。 DeCAL 能有效,主要有几个原因:
- 它在 latent 空间预测,而不是像素空间逐帧预测
- 生成的是 Cosmos VAE latent、触觉 latent。
- 这些 latent 更抽象,也更关注任务相关变化。
- 历史和当前观测已经包含大量时序信息
- 模型不是凭空预测未来,而是基于过去 15 帧左右的历史,约 0.5 秒的上下文。
- 短期未来动力学可以从历史运动趋势中推断。
- 视觉和触觉联合建模
- 视觉告诉模型物体和手在哪里。
- 触觉告诉模型是否真的接触、接触是否稳定、力如何变化。
- 联合预测让模型能推理“如果我继续这样动,接触状态会怎么变”。
动作专家
以理解专家和生成专家的潜在特征,以及机器人本体感受状态 (q_t) 为条件,使用 flow matching 目标预测动作片段 (a_{t:t+H})。
由于机械臂和灵巧手动作在动力学特性和控制粒度上差异显著,如果通过共享去噪过程联合建模二者,可能掩盖细粒度灵巧行为,并在高自由度设置下削弱机械臂与手之间的协调。 于是提出 Factorized Flow Matching,显式解耦机械臂动作与手部动作生成。
具体而言,机械臂动作和手部动作从独立噪声分布初始化,并通过 MLP 层投影到不同的 token 序列(这里解耦)。这些 token 随后共同经过 Transformer 块处理,实现协调的动作生成(表示层解耦,交互层不隔离),最后被解码为干净的动作轨迹。生成专家和动作专家均采用 Qwen3 作为骨干网络。
跨模态联合注意力
如图 3 所示,实现分块注意力掩码来控制专家间的信息流动
信息从理解专家单向传播到生成专家,再传播到动作专家;后续专家中的 token 可以关注前序专家中的 token,但反向注意力被禁止。
在理解专家和生成专家内部,token 采用双向注意力,以增强多模态推理和表征学习。
在动作专家中,状态 token 可以关注自身及所有前序块;动作 token 可以关注自身、状态 token 以及所有前序块。
自适应视觉-触觉融合
触觉特征提取。
使用多指形变图作为触觉输入,因为它包含丰富的几何接触信息。
一个共享的基于 ResNet [57] 的触觉编码器从所有指尖提取触觉特征。特征先进行空间池化并投影为触觉 token,随后通过 Transformer 层融合,以捕捉跨手指交互和整体接触模式。
编码器最终输出两类互补表征:一是保留细粒度接触细节、用于视觉-触觉交互的局部触觉 token;二是总结整体接触状态、用于接触感知触觉门控的全局触觉 token。
自适应视觉-触觉交叉注意力
为了将触觉反馈纳入视觉-语言嵌入,在每个 Transformer 块中引入交叉注意力机制。
局部触觉 token 作为键和值,由 Transformer 输入经前缀投影得到的向量作为查询。
融合输出随后通过残差连接加入该块的联合自注意力嵌入中,使模型能够整合触觉线索,同时保留原有的多模态上下文。
接触感知门控机制
物理接触通常是间歇性的,只在任务的特定阶段出现,而非始终存在。
提出 Contact-Aware Gating Mechanism,使策略能够根据每个时间步接触信息的相关性,自适应调节触觉输入的权重。形式上,门控输出计算为:
其中 (X) 表示输入到 Transformer 层的原始嵌入,(Q_{vl}) 是来自视觉-语言嵌入的查询,(K_{local}) 和 (V_{local}) 分别是作为键和值的局部触觉 token。门控权重 (\sigma) 由全局触觉 token (z_{global}) 经过轻量投影函数 (\mathrm{Gate}(\cdot)) 得到。
视觉-触觉潜在协同想象
生成专家执行面向未来的潜在想象,以联合建模视觉-触觉动力学。给定历史和当前视觉-触觉观测,模型生成能够刻画交互底层物理动力学的预测性潜在表征。
触觉潜在预测
6 自由度接触力提供了一种紧凑且物理意义明确的接触动力学表征,同时捕捉力的大小和力矩信息。
在触觉潜在预测中,每个指尖的力先由专用力编码器映射为嵌入,再由策略处理生成触觉潜在表示。该潜在表示随后可被解码为不同粒度的表征,包括原始图像、形变图和 6 自由度力向量。这些表征从多个角度捕捉触觉动力学,为具有物理依据的场景理解和动作生成提供支持。
视觉潜在预测
通过根据历史和当前观测生成未来视觉潜在表示,为 DeCAL 注入世界知识。这种前瞻表征提供了带时间上下文的线索,可增强接触丰富操作任务中的规划与决策。
使用 Cosmos VAE tokenizer [61] 编码多视角视觉图像,它既能提供表达力强的视觉潜在表征,又能保留细粒度细节。 为了高效处理长视觉序列,我们进一步参照 Cai et al. [41] 引入 token 压缩机制。 具体而言,(32\times32) 的潜在特征网格通过一个 (8\times8) 卷积层下采样到 (4\times4),在减少序列长度的同时保留关键空间信息。压缩后的 token 随后被并行解码,以生成未来视觉帧,并利用来自理解专家的 KV cache。
训练时,预测的视觉潜在表示直接回归到由未来视觉观测编码得到的 Cosmos VAE 目标。触觉潜在表示则以当前 6 自由度力为条件,通过重建未来原始触觉图像、形变图和 6 自由度力进行间接监督。推理时,生成专家联合预测未来视觉和触觉潜在表示,为动作生成提供前瞻上下文;重建解码器则被省略,以避免不必要的像素级重建。
实验
实验设置
硬件平台
- 双 6-DoF UR5 机械臂 + 双 22-DoF SharpaWave 五指灵巧手。
- 视觉:1 个第一视角相机 + 2 个腕部相机,均为 Intel RealSense D435。
- 触觉:每个指尖配备 320×240 高分辨率视觉触觉传感器。
- 系统控制频率:30 Hz。
任务与数据
- 共 6 个真实世界接触丰富、细粒度灵巧操作任务:
- Wipe Vase:擦拭花瓶
- Erase Whiteboard:擦白板
- Assemble Parts:插头/插座装配
- Twist Cap:拧瓶盖
- Pipetting:移液操作
- Screw Light Bulb:拧灯泡
- 每个任务采集 100 条高质量示教,默认每任务测试 20 次。
- 示教通过 MetaGlove Pro + VIVE Trackers 遥操作采集。
训练设置
- 从 InternVLA-A1-3B 预训练权重初始化。
- 8 张 NVIDIA H100 训练,每卡 batch size 为 4。
- AdamW 优化器,学习率 5e-5,2000 步 warmup,之后线性衰减至 5e-6,共 100k 步。
- 使用过去 15 帧历史观测,约 0.5 秒时间上下文。
- 动作片段长度为 50。
评价指标
- Success Rate, SR:任务是否完整成功。
- Progress Rate, PSR:任务各阶段平均完成率,用于反映细粒度进展。
实验设计
论文主要围绕两个问题设计实验:
- DeCAL 相比 SOTA 策略是否更强?能否泛化到 OOD 场景?
- 主实验:6 个真实任务上与多个 VLA 和触觉策略对比。
- 泛化实验:未见背景、杂乱环境、未见光照、未见物体。
- 方法中的关键组件是否有效?
- 消融实验:
- Factorized Flow Matching
- Tactile Gating
- Visual Latent Generation
- Tactile Latent Generation
- 消融实验:
另外还补充了三组机制分析:
- 触觉全局 token 的 t-SNE 可视化;
- 接触阶段中 tactile gate 的变化;
- 预测 6-DoF 力与真实力的对比。
实验效果
真实任务主结果
| 方法 | 平均 SR |
|---|---|
| GR00T N1.6 | 31.7% |
| InternVLA-A1 | 33.3% |
| ViTacFormer | 47.5% |
| DECO | 55.8% |
| InternVLA-A1t | 39.2% |
| DeCAL | 70.8% |
核心结论:
- 纯视觉策略在较简单任务上可用,但对精细接触控制不足。
- 简单拼接触觉信号的 InternVLA-A1t 并没有稳定带来收益,说明直接注入触觉可能干扰视觉表征。
- DeCAL 通过自适应视觉-触觉融合和视觉-触觉联合动力学建模,在保持视觉定位能力的同时增强物理交互感知。
泛化实验
以 Twist Cap 为例,测试四类 OOD 场景:
- 未见背景
- 杂乱环境
- 未见光照
- 未见物体 DeCAL 在所有 OOD 设置下均优于 ViTacFormer 和 DECO。最关键的是在 Unseen Object 场景下,DeCAL 最终成功率达到 75%,显著超过最强基线。论文分析认为这是因为它建模的是可迁移的接触交互模式,而不是只依赖外观特征。
消融实验
| 设置 | Assemble Parts SR | Twist Cap SR |
|---|---|---|
| 去掉 Factorized FM | 25.0% | 35.0% |
| 去掉视觉/触觉生成 | 20.0% | 30.0% |
| 只保留触觉生成 | 35.0% | 45.0% |
| 只保留视觉生成 | 55.0% | 60.0% |
| 去掉 Tactile Gating | 50.0% | 70.0% |
| 完整 DeCAL | 65.0% | 80.0% |
主要结论:
- Factorized Flow Matching 最重要之一:去掉后机械臂与灵巧手协调明显变差。
- 视觉/触觉 latent generation 都有贡献:为动作生成提供未来动力学先验。
- Tactile Gating 有效:避免触觉信号在弱接触或无接触阶段干扰策略。
未来视觉生成质量
| 任务 | 指标 | InternVLA-A1 | DeCAL |
|---|---|---|---|
| Assemble Parts | Cosmos Similarity ↑ | 0.913 | 0.946 |
| Assemble Parts | LPIPS ↓ | 0.243 | 0.222 |
| Twist Cap | Cosmos Similarity ↑ | 0.908 | 0.927 |
| Twist Cap | LPIPS ↓ | 0.257 | 0.245 |
机制分析
- 触觉表示结构化:t-SNE 显示不同接触模式,如 twist、insert、wipe,在全局触觉 token 空间中形成明显聚类。
- Tactile Gate 符合接触阶段变化:无接触时 gate 值低,策略主要由视觉主导;发生有效接触后 gate 值升高,触觉对动作生成的影响增强。
- 力预测准确:预测的 6-DoF 力曲线与验证集真实值高度一致,说明 latent co-imagination 能捕捉底层接触动力学。
总结
实验部分的核心论点是:DeCAL 不只是加入触觉模态,而是让视觉、语言、触觉在未来动力学空间中联合推理。
关键贡献在实验中对应三个证据:
- 主实验强:6 个真实灵巧操作任务全部取得最高 SR。
- 泛化强:在未见背景、光照、杂乱和未见物体下都保持领先,尤其未见物体成功率达 75%。
- 组件有效:Factorized Flow Matching、触觉门控、视觉/触觉 latent generation 都能显著提升接触丰富任务表现。
对方法学习的启示:
- 触觉信号不宜简单拼入 VLM,需要按接触状态自适应调制。
- 机械臂和灵巧手控制粒度差异大,显式解耦生成过程很重要。
- 未来视觉-触觉 latent 预测可以作为隐式世界模型,为 action expert 提供物理交互先验。
总结
提出了 DeCAL,一个具有物理基础 的灵巧视觉-语言-动作模型,能够有效利用触觉反馈,完成接触丰富的操作任务。
通过在协同框架中统一理解、生成与动作生成,DeCAL 实现了连贯的多模态推理和细粒度灵巧控制。此外,DeCAL 通过接触感知的触觉门控机制自适应融合视觉-触觉信息,并通过面向未来的潜在想象建模视觉-触觉动力学,从而赋予策略隐式世界知识。在真实世界灵巧操作任务上的大量实验证明了该方法的有效性和泛化能力。
局限性
论文明确提到三点主要局限:
- 依赖精确触觉感知
- DeCAL 的性能依赖于触觉感知质量。
- 触觉传感器可能受到噪声、标定误差和模型漂移影响。
- 在长期运行或高负载操作中,这些因素可能导致性能下降。
- 遥操作系统缺乏指尖力反馈
- 数据采集时,操作者无法通过遥操作系统感知指尖力。
- 这可能导致接触调整延迟、接触控制不够最优。
- 因此也会限制触觉感知示教数据的质量。
- 缺少大规模视觉-触觉预训练
- 当前框架尚未利用大规模视觉-触觉数据进行预训练。
- 作者认为,扩展多样化的触觉灵巧操作数据并进行预训练,可能进一步提升模型能力,这是未来重要研究方向。