How Much Can Best-of-N Help a World Action Model? Measuring Selectable Headroom and Realizing It in Closed Loop
How Much Can Best-of-N Help a World Action Model? Measuring Selectable Headroom and Realizing It in Closed Loop
一句话总结
本文研究 WAM 中 Best-of-N 动作选择到底有多少可实现的提升空间。传统方法对每个候选只执行一次,再取最终结果最好的候选,会把动作质量与后续执行的随机性混在一起,从而高估选择收益。作者提出去噪反事实评估协议,通过同状态分支、重复延续、留出评估和共同随机数,测量候选之间真正可利用的成功概率差异。实验发现,原生采样的真实余量有限,结构化动作扰动能够创造余量,而 WAM 的想象表征已包含候选排序信息,只是价值头未能充分利用。基于这些发现,作者设计了“预测原策略失败时才干预,再对扰动候选排序”的选择器,提高了闭环成功率,并将评估协议与分支数据整理为 HeadroomBench。
摘要
世界动作模型(WAMs)能够预测其所生成动作的视觉后果,这使得测试时选择(test-time selection)成为改进一个固定策略的自然手段:想象若干候选动作的未来,然后执行其中最好的一个。
选择带来的收益受限于可选择余量(selectable headroom),即最佳候选动作实际上能够好多少;但标准估计方法对每个候选动作只执行一次,然后取其中最好的结果,这会将候选动作本身的质量与后续所有过程的随机性混为一谈。
我们提出一套去噪的反事实协议(denoised counterfactual protocol),它基于按位可复现的分支执行(bitwise-reproducible branching)、重复续演(repeated continuations)、留出预言机(held-out oracles)和共同随机数(common random numbers),用来度量一个选择器真正能够兑现的提升空间,并利用这些度量构建了一个失败门控选择器(fail-gated selector)。
引言
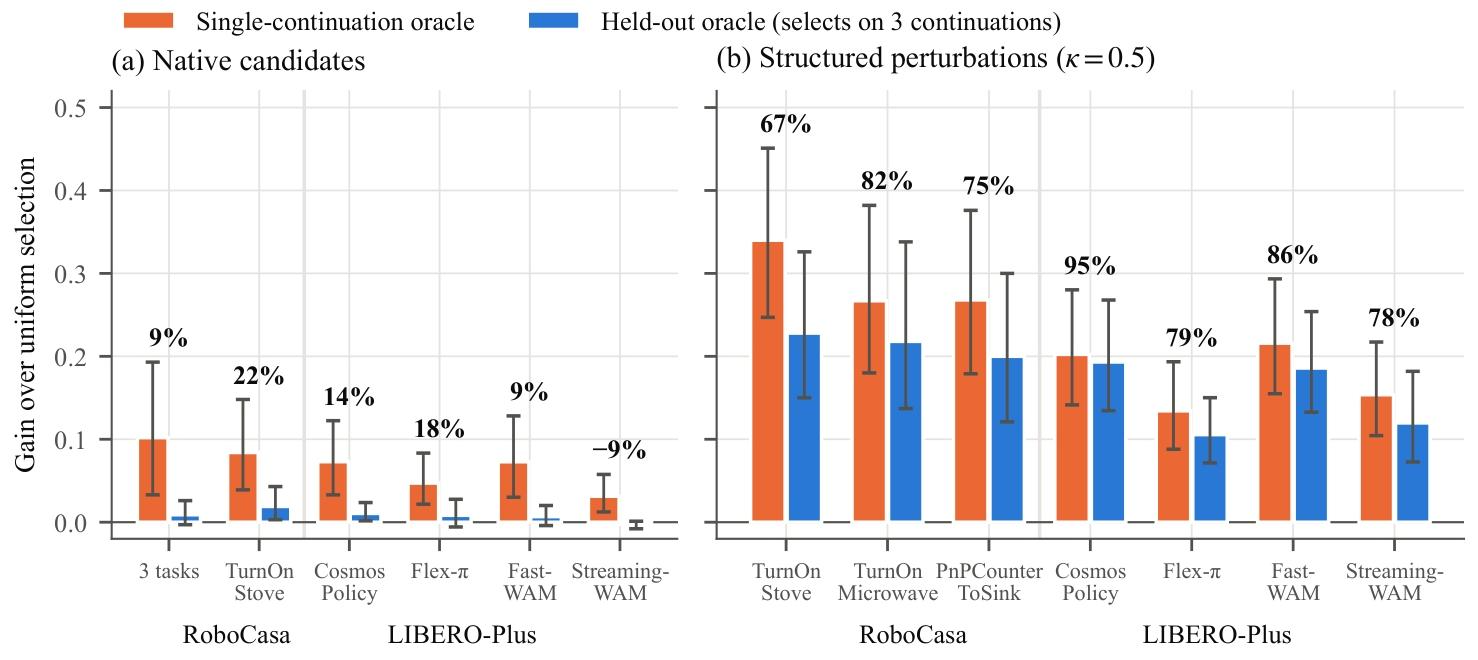 图1. 测得的提升空间中有多少是可选择的?橙色:单续写 oracle(最佳已实现结果)。蓝色:留出 oracle,它在三个续写上做选择,并在一个全新的续写上评分。百分比:留出份额 ,即可选择份额的下界。对于原生样本(a),该份额在两个基准和全部四个模型上至多为22%;对于结构化动作扰动(b),该份额为67–95%。误差棒:由按状态聚类的 bootstrap 得到的95%置信区间。
答案在候选被挑出之前就已经固定了:收益上界取决于最优秀的那个候选在池中究竟好多少。我们把这一量称为可选择余量(selectable headroom)。 通过反事实分支(contrastive branching)直接测量了它:固定同一个模拟器状态,各执行 16 个采样候选,每个候选再沿该策略续演至回合结束,结果显示,如果选择最终表现最好的候选动作,任务成功率可以从 68.9% 提升到 79.2%;然而,学习得到的价值函数、图像相似度指标和视觉语言模型(VLM)判断,只能恢复其中很小一部分收益。
提出了一种去噪反事实协议(denoised counterfactual protocol,见图 2a)。每个候选动作都从一个按位可复现的模拟器状态快照开始执行,并且在执行后继续运行多次。 使用一个留出式预言器来衡量可实现的余量:该预言器根据一部分延续过程进行选择,再使用另一部分独立的延续过程进行评估。 与此同时,通过方差分解区分候选动作本身的影响,以及候选动作与后续延续过程之间交互所产生的影响;并且让所有评估器使用共同随机数,从而确保所有候选动作都在相同的评估随机性下进行比较。
主要发现如下。
- 单次延续预言器主要受到延续过程随机性的支配(第 5.1 节)。按照 Yuan 等人的实验协议,我们复现了 12.3 个百分点的预言器收益;然而,即使一个选择器能够观察每个候选动作的三个独立结果,它在新的延续过程上也只能实现其中 9% 的收益。当改变延续过程所使用的随机种子时,候选动作特有的结果变化中有 98% 会被重新随机生成。在 LIBERO-Plus 上的四个 WAM 中也观察到了相同现象。对于每个候选动作使用 17 次延续后,Cosmos Policy 的可选择余量仅为单次延续预言器收益的 24% 至 52%;对于 Flex-π 和 Fast-WAM,这一比例则约为三分之一至三分之二(见图 1)。
- 结构化候选方案能够创造可选择余量(第 5.2 节)。原生采样得到的动作几乎彼此相同,相比策略原本输出的动作片段,几乎没有可选择余量。相反,沿机器人坐标轴对策略动作片段进行位移,可以创造出可选择余量;对于四个 WAM,这些余量中有 67% 至 95% 在留出评估中仍然存在。这些余量主要出现在策略动作片段会失败的状态,并且在两个基准测试和四个 WAM 上,都比原始动作片段高出 4.5 至 16 个百分点。
- 想象得到的未来包含了价值头所遗漏的信号(第 5.3 节)。在两个具有动作条件想象能力的 WAM 上,使用想象未来训练得到的线性读出器对候选动作进行排序,其表现相较于使用真实未来训练的相同读出器没有可检测的损失。对于 Cosmos Policy,这一信号存在于预测得到的后果中,而不是动作本身的编码中。尽管价值头在状态层面具有较高准确率(AUROC 为 0.90),但它几乎无法恢复这一信号。
- 基于上述发现构建的选择器能够改进原策略(第 5.4 节)。一个学习得到的失败门控器决定是否偏离策略原本输出的动作片段;另一个学习得到的排序器决定应该朝哪个方向偏离。因此,选择器只在策略可能失败的地方进行偏离,也就是可选择余量最有可能存在的地方;在其他情况下,则保持原策略动作片段不变。该选择器经过冻结,并按照预注册方案进行评估后,在训练任务的保留测试回合上,将闭环任务成功率从 76.9% 提升到 81.6%;在策略最容易失败的状态下,成功率提高了 10.7 个百分点。此外,在不使用测试任务重新训练的情况下,它还将未见任务上的成功率从 62.6% 提升到 69.8%。
这些结果说明了测试时选择机制何时能够帮助 WAM:值得追求的余量来自于能够显著偏离策略原动作片段的候选方案,而不是来自原生采样得到的动作;模型所想象的未来已经包含了对这些候选动作进行排序所需的信息;真正缺少的是一种经过训练、能够比较同一状态下相互竞争动作的读出器,而不是单纯评估状态价值的模型。
综合来看,这些结果为 WAM 中的测试时计算提供了一个具体方案:在策略可能失败的状态下,针对具有实际影响的候选动作投入计算资源;使用基于分支结果训练的读出器对候选动作进行评分;并且通过留出式预言器,在每个候选动作只需额外执行一次延续的代价下,提前知道选择器能够获得多少收益。我们将这一协议及其分支数据整理为 HeadroomBench(第 6 节),并计划公开发布。
方法
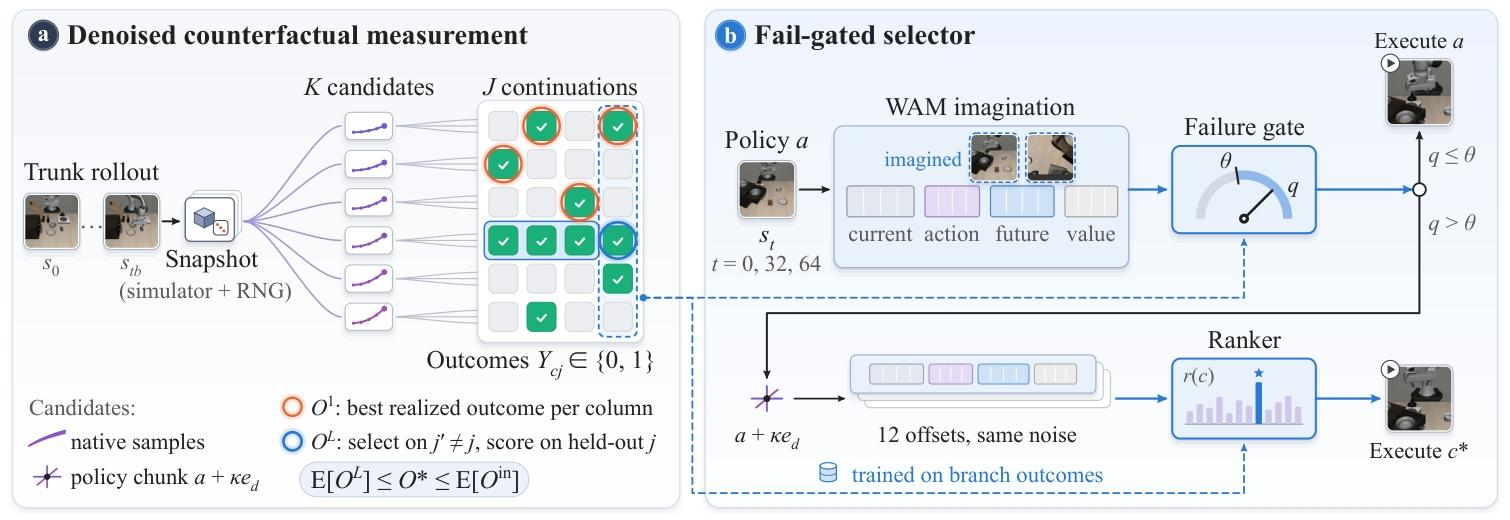 图2. 概述。(a) 从 处一个逐位可复现的快照出发,执行 K 个候选块中的每一个,并由策略将其继续 J 次。(橙色)取每列中最佳已实现结果;(蓝色)在其余列上进行选择,并在留出的一列上评分。这里每一列都包含一次成功,但只有一个候选在每次续写中都成功。(b) 在步骤 0、32 和 64,一个失败门读取想象出的策略块 的表示;仅当其得分 超过 时,才对 的十二个轴偏移用相同噪声进行想象并排序。两个读出均基于分支结果(虚线)训练,而非取自价值头;(b) 中的帧来自图5的回合。
可选择余量(Selectable headroom)
在决策点 ,策略输出一个动作片段,并执行其前面一部分,然后再次查询策略;对于 Cosmos Policy,这一执行长度为 16 步。 对于候选动作 ,令 表示:从 开始,先执行 中实际需要执行的部分,再由原策略接续控制时,任务成功的概率。这里的随机性来自之后所有的策略查询。
相对于在 个候选动作中均匀随机选择,可选择余量定义为:
当候选池包含策略原本输出的动作片段 时,我们还报告 ,即相对于直接执行该动作片段的收益。
按位可复现的分支执行(Bitwise-reproducible branching)
我们对完整的 MuJoCo 状态、全局随机数状态,以及 RoboCasa 在关节位置之外单独维护的固定设施状态(例如炉灶火焰)进行快照保存和恢复。 从快照开始执行分支,可以逐字节复现从环境重置开始、使用指定随机种子运行得到的轨迹,包括动作、本体感知信息、相机画面和成功标志。
重复延续与留出式预言器(Repeated continuations and held-out oracles)
令 表示候选动作 在第 次延续过程中的结果,并令:
我们比较以下三个估计量:
其中:
先把第 次延续的结果留出来不用,再根据其余延续的平均表现,选出最好的候选动作。 就是这样选出的最优候选动作集合。若有多个候选动作并列最优,则对它们取平均。
是标准的单次延续预言器。它只取决于每一列是否存在成功结果,因此,在一列内打乱候选动作的标签不会改变它的值;它无法区分候选动作本身的质量与延续过程中的运气。相当于:看完这一次哪个动作完成了任务,再说“我选它”
先按每一行的平均表现选动作,再用同一批结果评分,先计算每个候选动作在全部 次延续中的平均成功率,选出平均值最高的动作,再用这同一批数据衡量收益。相当于:试运行几次任务选出成功率最高的动作,再拿这几次的成绩证明动作好。
用于选择的延续过程,与用于评估所选动作的延续过程相互独立,因此,它衡量的是一个能够观察每个候选动作 次结果的选择器所能实现的收益,相当于:先试运行选出最优动作,再让动作执行新的一轮,看它还成不成功,并且有:
其中, 是样本内预言器,详见附录 C。我们报告在各个决策点上计算得到的加权均值 、 和 ,以及留出比例:
原先看起来能提升的收益,有多少在“先选动作、再用没参与选择的结果验收”之后,还能实现? 分母 :看完每次结果,再挑赢家,算出来的收益。 分子 :根据其他几次结果选动作,再用留出的那次结果验收,算出来的收益。
| 名称 | 大白话 |
|---|---|
| 真实余量 | 真知道谁最好,最多能提升多少? |
| 单次延续余量 | 看完这次结果,再挑赢家,看起来提升多少? |
| 样本内余量 | 用一批成绩选冠军,再用原成绩评价,提升多少? |
| 留出余量 | 用旧成绩选冠军,拿没参与选择的成绩验收,提升多少? |
这篇论文最想指出的是:看完结果总能找到赢家,不代表你能在结果出来之前选中赢家。
方差分解(Variance decomposition)
不同候选动作的延续过程可以彼此独立,也可以共享同一套随机种子安排。在共享随机种子安排时,采用如下双因素模型:
该模型将候选动作效应 ,与随机种子安排效应,以及“候选动作 × 延续过程”的交互项 区分开来。任何选择器都无法利用这一交互项。对于结构化候选方案,我们进一步将 分解为所有状态共享的方向主效应,以及状态与方向之间的交互效应。
| 项 | 含义 |
|---|---|
| 大家总体是什么水平 | |
| 动作 是否通常比其他动作更好 | |
| 第 轮是否普遍让大家更容易成功 | |
| 动作 在第 轮的表现,超出了前面几项能解释的部分 |
高效采样(Efficient sampling)
在大多数决策点,所有候选动作的结果都相同。因此,我们首先只对每个候选动作执行一次延续。对于候选动作结果存在差异的决策点,以及从其余决策点中通过哈希选出的四分之一(权重设为 4),再执行更多次延续。
估计时只使用第二阶段的延续结果,并按照采样概率的倒数进行加权。置信区间(CI)通过以状态为聚类单位的自助法(bootstrap)获得。
候选方案(Proposals)
原生候选动作是从策略中独立采样得到的。结构化候选动作则沿机器人基座坐标系的六个轴向 ,对策略原动作片段 施加位移:
动作中的姿态和夹爪控制保持不变。取 时,末端执行器的位移分别约为 2、5 和 10 厘米。加上原始动作片段 ,每个扰动尺度下共有七个候选动作。
读取想象表征(Reading the imagination)
价值头既可以对动作执行后的真实状态进行评分,也可以按照部署时使用的想象流程进行评分:在 查询策略,注入候选动作片段,由世界模型生成未来,再由价值头对其评分。
为了检验冻结后的表征是否编码了“哪个候选动作能够成功”的信息,我们还拟合了线性探针。这些探针利用 Transformer 最后一个模块中未来帧位置的 token,预测同一决策点内各候选动作的结果 ,并在每个决策点内进行中心化。
这些探针采用加权对偶岭回归,并通过留一状态法训练。我们还利用其他状态估计出的全局方向效应,对探针预测进行残差化处理,使探针不会因为识别出一个在所有状态下都表现良好的方向而获得额外评价。
使用的统计量是决策点内的 Spearman 相关系数 。其零分布通过在各决策点内置换结果标签、并重新拟合整个流程获得;计算 值时,将观测到的统计量也计为一次置换结果。所有评估器所用的随机种子均独立于候选动作。
实验设置
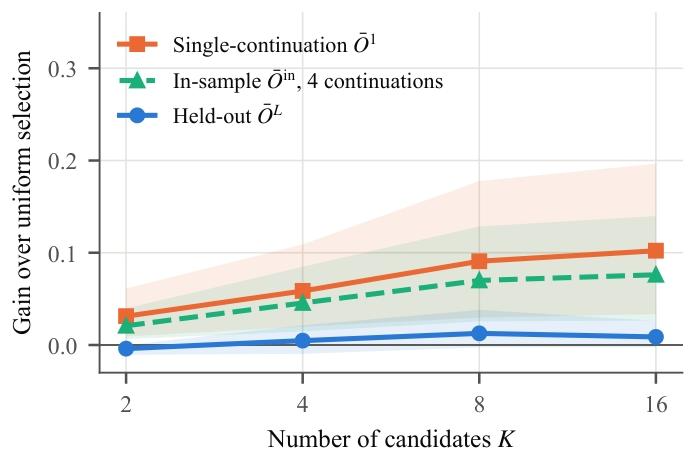 图3. 在 Yuan 等人的协议下,提升空间随候选数量的变化(三个 RoboCasa 任务,16 个原生候选,续写种子在候选之间共享)。单续写 oracle 随 K 持续上升,而留出 oracle 则保持在接近零的水平。阴影:95% 置信区间。
模型与基准测试(Models and benchmarks)
在 RoboCasa 上,使用 Cosmos Policy 公开的 RoboCasa 模型检查点。该模型包含 20 亿参数,平均成功率为 67.1%,由 Cosmos 视频世界模型微调得到。
其公开的价值头仅在示范轨迹回放上训练过。使用 1,200 条策略运行轨迹对其进行微调,并在全部实验中使用训练至 15,000 步的模型。
在 LIBERO-Plus 这一基准上,使用 Cosmos Policy、Flex-π 、Fast-WAM 和 Streaming-WAM 公开发布的 LIBERO 检查点。在 LIBERO-10 上复现了各模型的性能,成功率均落在其公开报告结果的置信区间内。
在收集任何分支数据之前,预先确定了一条规则:选择所有模型成功率都处于 30% 至 90% 之间的扰动类别进行评估。最终选定的两个类别是“物体布局”和“机器人初始状态”。
全部四个 WAM 都参与可选择余量的测量。其中,两个公开检查点能够想象给定动作后果的模型——Cosmos Policy 和 Streaming-WAM——参与想象表征探针实验;后者根据最初执行的 8 步动作生成想象结果。选择器则基于 Cosmos Policy 构建。
数据与预注册(Data and pre-registration)
共收集了十二个分支数据集,其中四个来自 RoboCasa,八个来自 LIBERO-Plus。每个数据集使用独立的随机种子集合;初始状态哈希确认,对于每个模型,各数据集之间不存在重叠,也不与评估回合或训练回合重叠。
正文中的每一项验证性检验都经过预注册:在收集相应数据之前,就已登记所使用的数据、统计量和判定标准。
实验结果
第五章围绕四个问题展开:Best-of-N 到底有多少真实提升空间?如何创造这种空间?模型能否识别更好的动作?最终能否提高闭环成功率?
实验覆盖四个 WAM 和两个仿真基准 RoboCasa、LIBERO-Plus。核心设计是在同一状态下执行不同候选动作,并对每个候选重复多次后续策略执行,以区分“动作本身更好”和“后续过程碰巧顺利”。
5.1 传统预言器是否高估了选择收益?
实验设计与原因: 传统做法对每个候选只执行一次,再选择最终成功的动作。但最终结果同时受候选动作和后续策略随机性的影响,因此,“这次成功”未必意味着“这个动作更好”。作者让每个候选重复多次延续,并比较:
- 单次延续预言器:直接取本次结果最好的候选。
- 留出式预言器:根据部分延续结果选动作,再在独立的延续中评估。
- 方差分解:判断结果差异主要来自动作本身,还是后续过程的随机性。
结果: 传统协议下可观察到约 12.3 个百分点的收益,但根据每个候选的三个结果进行选择后,在新延续中只能实现约 9% 的原估计收益。随着候选数量增加,传统预言器的收益持续上升,留出式收益却基本不变。增加到每个候选 17 次延续后,三个模型的真实可选择比例仍被夹在约 24%–66% 的范围内。
结论: 原生采样下,传统 Best-of-N 上限很大程度上来自对随机性的择优。评估选择方法时,应同时报告留出式收益,避免将“选中了幸运轨迹”理解成“找到了更好的动作”。
5.2 怎样产生真正可利用的候选差异?
实验设计与原因: 如果策略原生采样的动作几乎相同,选择器再强也难有收益。作者因此比较原生采样与结构化扰动:沿机器人坐标轴对原动作施加不同幅度的位移,再测量留出式收益。
结果:
- 原生候选之间差异很小,相对原策略动作几乎没有可靠收益。
- 结构化扰动产生了约 4.5–16 个百分点的可选择余量,传统估计收益中的 67%–95% 能在留出评估中保留。
- 但扰动动作的平均表现反而比原动作低 7–14 个百分点;收益主要集中在原策略容易失败的状态,而且最优扰动方向随状态变化。
结论: 有效候选需要带来实质性的动作变化,但不能盲目扰动。选择器必须同时判断何时应该修改动作,以及当前状态下应该如何修改。
5.3 想象的未来是否足以判断动作优劣?
实验设计与原因: 价值头选不好动作,可能是世界模型没有预测出关键差异,也可能是价值头未能利用已有信息。作者固定模型,使用相同类型的线性探针,分别从想象未来和真实未来的内部表征中预测候选动作结果,并与价值头比较;同时控制全局方向偏好,检查信号是否只是来自动作编码。
结果:
- 价值头能较准确地判断一个状态最终是否成功,但对同一状态下不同候选动作的排序几乎无效。
- 想象未来中的表征能够有效区分候选优劣;在两个具有动作条件想象能力的模型上,与真实未来相比,未检测到超出预设等效界限的性能损失。
- 对 Cosmos Policy,未来表征在去除动作编码能够解释的部分后,仍保留结果信息,说明信号确实来自预测后果。
- 一个有代表性的比较是:RoboCasa 条件平均下,想象未来探针的排序相关性为 0.19,真实未来为 0.15,价值头仅为 0.01。
结论: 在本文评估的预测范围内,世界模型已经包含可用于选择动作的信息,主要瓶颈在于价值头的读取方式。判断“哪个状态更好”和判断“同一状态下哪个动作更好”,需要不同的训练目标。
5.4 能否把这些发现转化为实际策略提升?
实验设计与原因: 根据前述发现,作者将选择拆成两步:失败门控器决定是否偏离原策略;门控触发后,再由排序器选择结构化扰动。实验依次检验单决策点收益、完整闭环执行和未见任务泛化,并用“门控+随机扰动”“门控+固定方向”作对照。
| 评估场景 | 主要结果 |
|---|---|
| 单决策点 | 相比原动作提升 2.0 个百分点;随机扰动下降 1.9 个百分点,固定方向基本无收益 |
| 训练任务的留出回合 | 成功率 76.9% → 81.6% |
| 机器人初始状态扰动 | 成功率 65.1% → 75.8%,提升最明显 |
| 选择器未见过的任务 | 成功率 62.6% → 69.8% |
结论: “预测失败后再干预,并根据状态选择方向”能够将可选择余量转化为闭环收益,也具备一定任务泛化能力。
需要保留一个细节:在训练任务内部,仅使用当前状态和动作方向的排序器已接近完整模型,因此这些结果尚不能证明,想象未来是取得收益的必要条件。
实验结论
第五章形成的证据链是:传统估计混入了后续随机性 → 结构化扰动创造真实余量 → 想象表征包含动作排序信息 → 失败门控与排序器将部分余量转化为闭环提升。
这些结论来自可精确恢复状态的仿真实验;想象与真实未来的接近程度,也仅在本文模型、预测范围及预设统计界限内得到验证。
HeadroomBench
测量方法重复执行的成本较低,而其产生的分支数据恰好也是训练选择器所需要的数据,因此,我们将二者整理为 HeadroomBench,以供公开发布
对于任何支持指定随机种子查询的策略,以及任何支持状态快照的模拟器,余量评测路线(headroom track) 都可以测量单次延续预言器、留出比例、相对于策略原动作片段的余量,以及方差分解,并提供以状态为聚类单位计算的置信区间,其成本接近标准协议。
选择器评测路线(selector track) 提供训练集、测试集和闭环评估回合列表,同时给出价值头、随机偏移以及我们提出的两种选择器的参考结果。
在其测试集上,留出式预言器相对于策略原动作片段能够获得 11 个百分点的提升,而使用价值头进行选择和随机选择都会造成 8–10 个百分点的下降,说明大部分可选择余量仍有待利用。
讨论与结论
测试时选择对世界动作模型的改进幅度,受到其可选择余量的限制。 单次延续预言器衡量的是:是否存在某个候选动作,其后续执行过程能够成功 而动作选择真正取决于:最佳候选动作究竟比其他候选动作好多少。 留出式预言器只需为每个候选动作额外执行一次延续,就能衡量后者。
通过在四个 WAM 和两个基准测试上的实验,我们发现:标准预言器的结果在很大程度上反映了延续过程的随机性;当候选方案在策略会失败的状态下对动作作出实质性改变时,才会出现真正的提升余量;而有助于发现这些余量的信息,已经存在于模型想象的未来之中,相比真实未来没有可检测的信息损失。
当学习得到的读出器预测原策略会失败时,选择器才偏离原策略。这样的选择器在新的决策点和闭环执行中都优于原策略,在原策略最容易失败的情况下收益最大,并且能够将约一半的闭环收益迁移到选择器训练时未见过的任务上。
局限性
我们的测量覆盖了四个 WAM,以及两个基于 MuJoCo 的基准测试;这些环境均支持按位可复现的分支执行。该协议只要求能够保存和恢复状态快照,并使用指定随机种子查询策略,因此可以扩展到任何提供这些能力的 WAM 和模拟器。
在真实机器人上,由于无法精确恢复某个状态,可以通过重复重置来近似估计留出式收益,但估计会受到重置噪声的影响。选择器本身在部署时则不需要恢复状态,因为它使用 WAM 的想象结果对偏移候选进行评分。
利用同一状态下不同候选动作的分支数据——也就是本协议所产生的数据——训练优势头(advantage heads),是进一步接近留出式预言器表现的一个自然方向。