WHAT MATTERS FOR WORLD MODELING IN VISION-LANGUAGE-ACTION MODELS?
WHAT MATTERS FOR WORLD MODELING IN VISION-LANGUAGE-ACTION MODELS?
一句话总结
WM-in-VLAs 在统一实验框架下,系统比较了将世界建模融入 VLA 的四种代表性范式,并考察了不同世界表征、策略骨干网络及任务条件对其效果的影响,揭示了各类设计的优势、局限与适用条件,为后续研究提供了实验依据和设计建议。
不存在普遍最优的集成范式,效果取决于世界表征、策略骨干网络和任务条件:
- WM-Align(隐式未来对齐):轻量、推理开销接近基线,域内静态操作表现较好;但动态任务收益有限,接入预训练 VLA 时可能产生负迁移。
- WM-Query(显式未来查询):在部分长时程任务中表现突出,但对任务和数据量较敏感,少样本条件下可能明显退化。
- WM-MoT(未来专家):整体表现较均衡,在域外鲁棒性、动态操作和预训练 VLA 兼容性方面优势突出,但需要承担额外计算开销。
- WM-Ext(外部世界预测器):少样本域内学习表现突出,与预训练 VLA 的兼容性较好,但对世界表征的选择较敏感,也会增加推理成本。
世界表征方面,DINOv3、SigLIP 等二维语义表征在不同范式下提供了更稳定的收益,而像素、几何和时空表征更依赖架构匹配。总体而言,世界建模在长时程与动态任务中的价值更突出,解耦式设计通常更稳健,但并非在所有场景下都占优。
摘要
现有方法(把世界模型融入VLA中)在世界表征、集成范式以及策略骨干网络等方面往往同时存在差异,因此很难判断,究竟哪些因素对于有效集成世界模型真正重要。
将现有研究归纳为四种具有代表性的范式:隐式未来对齐(Implicit Future Alignment)、显式未来查询(Explicit Future Query)、MoT 未来专家(MoT Future Expert)以及外部世界预测器(External World Predictor)
在统一框架中分别实现了这四种范式,并结合多种世界表征与策略骨干网络,在域内、域外、长时程、动态场景、少样本及真实世界等设置下,对它们进行系统评估。 本研究得到四项主要发现:
- 世界表征的有效性取决于所采用的集成范式,而二维语义表征(从二维图像中提取、包含物体与场景含义的特征表示)能够在不同范式下带来稳定的性能提升。
- 没有一种范式在所有情况下都最优,但采用解耦设计的 MoT 未来专家具有较强的整体竞争力,尤其在域外(out-of-domain,OOD)鲁棒性方面表现突出。
- 世界建模能够持续改善基于标准视觉—语言模型(Vision-Language Models,VLMs)构建的策略,而解耦设计与预训练 VLA 的兼容性更好。
- 在多种设置下,世界建模均能提升仅预测动作的基线模型的性能,其中在长时程任务与动态任务上的提升尤为显著。
引言
标准 VLA 主要依据当前观测来预测动作。由于没有对场景如何在机器人交互作用下演变进行建模,它们在长时程任务中往往表现不佳,也难以适应分布偏移或动态环境
为克服这一局限,一个很有前景的方向是将世界模型融入 VLA,使其能够预判世界的动态变化 现有研究所采用的世界表征、集成范式与策略骨干网络却各不相同。具体而言,它们在不同的 VLA 骨干网络上,将从像素细节到语义潜在表征等不同层次的表征,与隐式对齐、显式条件化等设计相结合。因此,实验中性能提升的真正来源仍不清楚:在将世界建模融入 VLA 时,哪些设计选择才具有根本性的重要作用,依然有待厘清。
在这些挑战中,以下四个核心问题尤为突出:
- 世界表征(World Representation): 对于机器人策略学习,是否存在一种普遍最优的世界表征?还是说,表征的有效性从根本上就与集成范式相耦合?
- 集成范式(Integration Paradigm): 不同集成范式之间存在哪些性能权衡?耦合式与解耦式世界建模,哪一种更有效?
- 骨干网络泛化(Backbone Generalization): 世界建模的集成范式能否在不同策略骨干网络上持续有效,包括未经机器人数据预训练的模型,以及经过预训练的机器人基础 VLA?
- 综合性能(Comprehensive Performance): 在多样化的任务条件下,不同世界建模集成范式的表现如何?
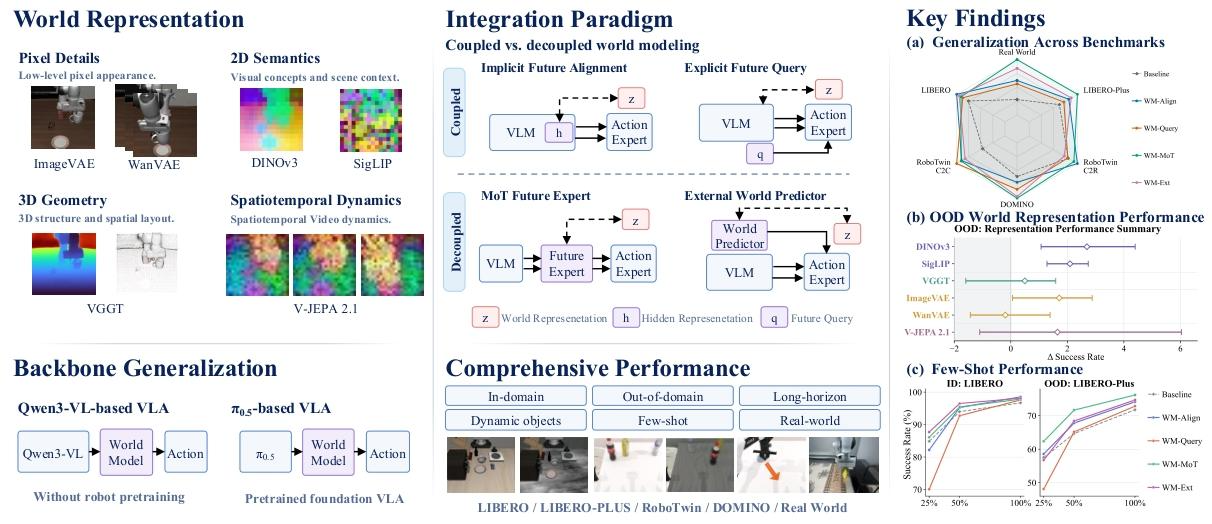 图1:围绕四个核心维度,对视觉-语言-动作策略中的世界建模进行系统性实证研究,涵盖世界表示、集成范式、骨干网络泛化性,以及在不同场景下的综合性能。
对 VLA 策略中的世界建模开展了系统性的受控实证研究,如图 1 所示。采用统一的实验流程,并在每组比较中使用相同的策略骨干网络与训练方案,系统回答上述四个核心问题。
- 为回答世界表征问题,考察了多种世界表征,涵盖像素细节〔ImageVAE、WanVAE〕、二维语义〔DINOv3、SigLIP〕、三维空间几何〔VGGT〕以及视频中的时空动态〔V-JEPA 2.1〕。
- 为回答集成范式问题,根据世界动态信息如何为策略提供条件,以及世界建模与策略之间的解耦方式,将现有架构形式化归纳为四种集成范式,即隐式未来对齐、显式未来查询、MoT 未来专家和外部世界预测器。我们在统一框架中分别实现这些范式的代表性设计。
- 为回答骨干网络泛化问题,我们在具有代表性的策略骨干网络上,对世界建模范式进行基准评估。这些骨干网络包括标准 VLM 骨干网络 Qwen3-VL-2B,以及专门面向机器人的基础 VLA 模型 π₀.₅。
- 为回答综合性能问题,我们在多种设置下评估这些集成范式,涵盖域内与域外分布、长时程任务、动态物体、少样本数据,以及真实世界实验。
大量实验得出了与上述核心问题对应的四项主要发现: (1)世界表征: 不存在一种在所有情况下都最优的世界表征。像素级特征带来的域内性能提升,并不总能转化为域外鲁棒性的增强;几何表征与时空表征的效果则对集成范式较为敏感。DINOv3 和 SigLIP 能够在不同范式下带来稳定的性能提升。 (2)集成范式: 没有一种范式能够在所有设置下占据优势,但采用解耦设计的 MoT 未来专家具有较强的整体竞争力,尤其在域外鲁棒性方面表现突出。隐式未来对齐较为轻量,但在动态任务上的效果相对有限;显式未来查询的表现则更依赖具体任务。外部世界预测器在数据量较少时取得了最佳的域内性能。 (3)骨干网络泛化: 集成世界建模的效果因策略骨干网络而异。世界建模通常能够改善基于标准 VLM 构建的策略;而在适配预训练基础 VLA 时,解耦设计表现出明显更好的兼容性。 (4)综合性能: 相较于仅预测动作的策略,世界建模能够带来明确的性能提升,尤其是在长时程任务与动态任务中。我们认为,这些系统性的研究发现,为将世界建模融入 VLA 系统提供了可操作的设计原则。
方法
预备知识
VLA 通常将预训练 VLM 骨干网络与可训练的动作专家相结合,把观测和指令映射为机器人动作。 给定输入观测 和指令 ,骨干网络分别将它们嵌入为视觉 token 与语言 token 。这些 token 经过 VLM 中连续的注意力层处理,得到联合多模态表征,随后由动作专家据此解码出连续的动作片段 。
将 Qwen3-VL-2B 骨干网络与采用逐层交叉注意力的 cross-DiT 动作专家配对,构建主要基线;此外,还使用 评估骨干网络泛化能力。
动作专家首先将带噪声的动作片段投影为 个动作 token ,它们在每一层通过交叉注意力关注视觉与语言 token:
遵循 Black et al.的方法,VLM 骨干网络与动作专家使用流匹配目标 进行联合训练。
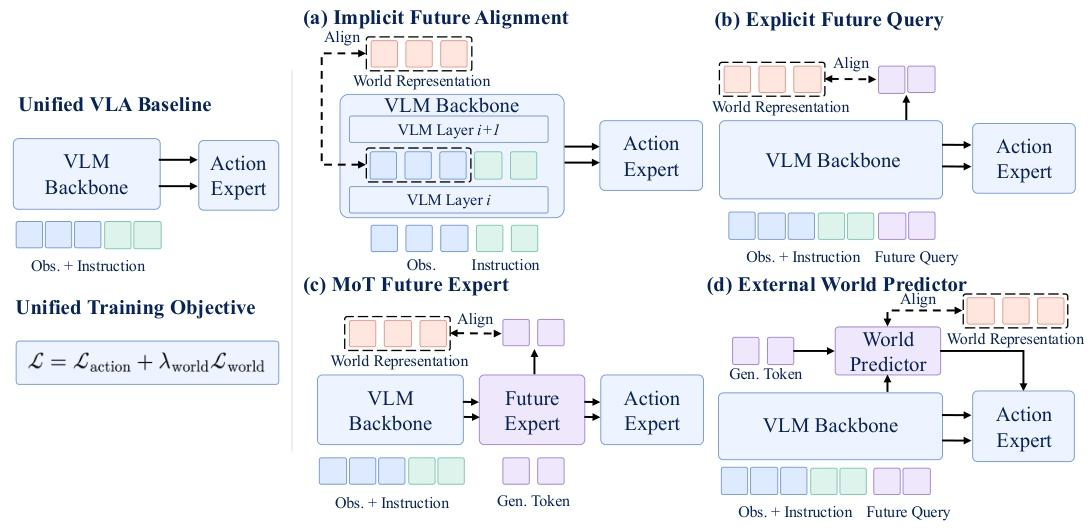 图2:视觉-语言-动作模型中四种代表性世界建模集成范式概览:(a)隐式未来对齐,(b)显式未来查询,(c)MoT未来专家,(d)外部世界预测器;分类依据是世界动态如何以策略为条件、以及如何与策略解耦。
下述具有前瞻能力的策略共享这一统一基线,区别仅在于它们如何将世界建模融入动作生成。为了给所有策略提供统一的监督目标,我们使用冻结的编码器 ,从未来观测 中提取世界表征 :
所有编码器接收相同的未来帧,以确保时间覆盖范围一致。对于图像编码器, 独立处理各个采样帧;对于视频编码器,则对整个序列进行联合编码。每种策略都会生成预测世界表征 ,并通过余弦相似度目标进行训练,使其尽可能与目标表征 对齐:
整个框架使用以下联合目标进行优化:
隐式未来对齐
在训练 VLM 时,通过一个小型 MLP,让 VLM 根据当前观测得到的内部表征,去预测并对齐真实未来画面经冻结编码器提取的特征,从而把对未来动态的预测能力融入 VLM。这里没有独立的世界模型,VLM 与 MLP 共同承担世界建模任务;推理时去掉 MLP,VLA 就能利用内部表征中学到的未来动态信息生成动作,无须额外运行世界预测模块。
如图 2(a)所示,隐式未来对齐不引入专门的架构模块,而是将世界建模表述为一个辅助表征学习目标,将世界动态信息直接注入 VLM 的隐藏表征中
具体而言,该策略对 VLM 的视觉表征施加监督,使其捕捉能够预测未来的世界动态信息。形式上,给定某个中间层的视觉 token ,一个轻量级多层感知机(MLP)预测器将其投影,使其与目标世界表征 对齐:
在这种预测监督下,中间视觉表征在保留当前语义上下文的同时,吸收未来世界的动态信息。
通过框架中的标准交叉注意力机制〔式(1)〕,动作 token 关注这些融入了动态信息的视觉表征,从而自然获得对物理变化的前瞻能力。在推理阶段,辅助预测器被移除,因此策略部署方式与基线完全一致。
显式未来查询
这个方法是在 VLM 的输入序列末尾加入一组可学习的未来查询 token,让它们通过 Transformer 的注意力机制汇总当前视觉与语言信息,并在每一层显式加入动作专家的交叉注意力上下文。训练时,通过解码器 将查询 token 的最终表征映射为未来特征,再与真实未来画面经冻结编码器提取的特征对齐,使查询 token 学会表达与任务相关的未来动态。推理时移除解码器,但保留查询 token,动作专家直接利用它们所携带的未来动态信息来生成动作。
如图 2(b)所示,显式未来查询通过在输入序列末尾追加一组紧凑的、可学习的未来查询 token ,来实现世界建模
这些查询位于序列末尾,通过关注前面的视觉与文本 token,将与任务相关的多模态上下文聚合为紧凑的预测性表征。隐式未来对齐保留了动作专家原有的标准交叉注意力上下文,而该策略在每一层都显式地将未来查询 token 加入上下文:
为了使这些未来查询 token 承担世界建模任务,我们将其最后一层的表征输入轻量级解码器 ,由其重建稠密特征,并与目标世界表征 对齐:
在训练过程中,这一预测目标促使未来查询 token 以紧凑形式捕捉以任务为条件的世界动态。在推理阶段,稠密特征解码器 被移除,动作专家可以直接利用所学到的动态信息,无须承担额外的预测开销。
MoT 未来专家
如图 2(c)所示,第三种策略通过专门的未来专家实现世界建模。未来专家作为混合 Transformer 架构中的一条并行分支,与 VLM 骨干网络和动作专家并行运行。
这一范式将世界建模任务从 VLM 骨干网络中解耦出来,使动作专家能够在各层中逐步与未来专家交互,从而利用中间层的世界动态信息。
具体而言,未来专家是一条从头训练的专用分支,对一组生成 token 进行处理。这些 token 使用冻结编码器 从当前观测 中提取的视觉特征进行初始化,随后经过逐步更新,用于解码目标世界表征。在每一层,未来专家仅与 VLM token 进行交叉注意力交互,以更新生成 token ,并保持与动作 token 隔离:
动作专家并非仅以最终预测表征为条件,而是在所有中间层同时与 VLM 和未来专家交互,以吸收逐层演化的世界动态信息:
在世界模型监督方面,一个轻量级 MLP 对最后一层的生成 token 进行投影,使其与目标世界表征 对齐:
在推理阶段,这个辅助投影头被移除,而未来专家则保留下来,作为内部世界模型分支指导动作生成。
外部世界预测器
外部世界预测器与MoT 未来专家都把世界建模交给了专门的模块,区别在于动作专家怎样使用它的信息。 MoT 未来专家与动作专家并行计算,动作专家在每一层都读取未来专家的中间表征,边预测未来、边生成动作;外部世界预测器则先输出最终的未来世界表征,再把这个预测结果加入动作专家的上下文,用来指导动作生成。所以,相比 MoT,这个方法不仅把世界预测做成独立模块,也把信息交互从“逐层读取中间特征”改成了“读取最终预测结果”;两种方法在推理时都会保留世界预测模块。
如图 2(d)所示,第四种策略——外部世界预测器——将世界建模解耦为一个独立模块,并显式地以最终预测的世界表征作为动作生成的条件
具体而言,该策略使用一个专门的多层 Transformer 作为外部世界预测器。预测器处理一组生成 token ,这些 token 使用冻结编码器 从当前观测 中提取的视觉特征进行初始化。
为了捕捉以任务为条件的动态信息,我们在 VLM 骨干网络中插入 个未来查询 token ,并利用其最后一层的表征,通过自适应层归一化(Adaptive Layer Normalization,AdaLN)对世界预测器进行调制:
为了利用预测世界表征 指导动作生成,动作专家将其直接加入交叉注意力上下文:
通过将预测结果与目标世界表征 对齐,对外部世界预测器施加世界模型监督:
在推理阶段,外部世界预测器被保留下来,显式提供预测世界表征 ,以供策略执行使用。
实验
实验目的与设置
实验围绕四个问题展开:选什么世界表征、如何接入策略、能否迁移到不同骨干网络,以及在哪些任务中最有效。
主要基线是 Qwen3-VL-2B + 动作专家,对比仅预测动作的策略与四种世界建模范式:WM-Align(隐式对齐)、WM-Query(显式查询)、WM-MoT(未来专家)、WM-Ext(外部预测器);另用预训练 VLA π₀.₅ 检验兼容性。每组比较共享数据、训练流程、未来帧与监督损失,尽量减少其他因素的干扰。
评估覆盖 LIBERO(域内操作)、LIBERO-Plus(域外扰动)、RoboTwin 2.0(不同任务时程与环境随机化)、DOMINO(动态操作),以及真实机器人任务,主要指标为任务成功率。
实验设计与结果
| 实验 | 为什么这样设计 | 主要结果与结论 |
|---|---|---|
| 世界表征比较 | 将像素、二维语义、三维几何和时空表征分别与四种范式组合,判断是否存在通用最优表征。 | 表征效果依赖集成方式:V-JEPA 在 MoT 中取得最高 OOD 增益,接入 Ext 却低于基线。DINOv3、SigLIP 在各范式下均有稳定收益,因此后续默认使用 DINOv3。 |
| 域内表现与域外鲁棒性 | 同时测试标准环境和视角、背景、语言等扰动,区分“训练分布内更准”与“真正更稳健”。 | 四种方法均提升平均成功率。Align 在 LIBERO 最好(96.7%→98.6%);MoT 在 LIBERO-Plus 最好(71.8%→76.2%)。域内优势不一定转化为域外优势。 |
| 长时程任务 | 按任务长度分组,检验未来预测是否对需要持续执行的任务更有帮助。 | 标准环境下,短任务提升 5.5–8.6 点,长任务提升 16.5–26.3 点;Query 在长任务上最强。随机化环境下,四种方法均改善长任务,但部分方法损害短任务。收益随任务条件变化。 |
| 动态操作 | 让目标物体持续运动,检验模型能否利用未来信息,而非仅依赖当前画面。 | 成功率由基线的 10.6% 提升至 MoT 的 15.5%、Ext 的 15.1%,高于 Align 和 Query。独立预测模块更适合动态任务,但绝对成功率仍低。 |
| 少样本学习 | 仅使用 25%、50%、100% 的示范,考察世界建模能否提高样本效率。 | Ext 的域内样本效率最好,MoT 的少样本 OOD 表现最好;Query 在 25% 数据下由基线 84.9% 降至 70.1%。增加未来预测目标并不必然节省数据。 |
| 预训练 VLA 兼容性 | 将相同范式接入 π₀.₅,判断在标准 VLM 上有效的设计能否直接迁移。 | MoT、Ext 在域内和域外均有增益;Query 基本持平;Align 在两种设置下均下降约 5 点。解耦设计与预训练 VLA 更兼容。 作者推测,直接对齐可能干扰已有表征与操作先验。 |
| 真实机器人验证 | 用静态、动态共四项任务,检查仿真中的趋势能否延续。 | 平均成功率从 45.0% 提升至 56.3%–73.8%;MoT 整体最好,解耦方法在动态任务上优势更明显。 |
关键消融:提升到底来自哪里?
- 排除“只是多了参数或视觉特征”:保持 MoT 架构和当前帧输入不变,分别使用无世界监督、当前状态监督、未来状态监督,OOD 成功率为 73.6%、74.0%、76.2%。说明未来预测本身确有额外价值。
- 拆分当前输入与未来监督的影响:交叉组合 DINOv3、V-JEPA 编码器。结果表明两者都会影响性能;Ext 使用 V-JEPA 作为预测目标时持续较差,进一步说明表征需要与架构匹配。
- 检查结果是否偶然:关键现象经三随机种子复现;调整损失权重、监督层和查询数量,可以缓解 Align、Query 的负面结果,但在测试范围内未能消除。
- 效率代价:Align、Query 的推理成本接近基线;MoT、Ext 需要保留预测模块,端到端延迟分别约为 136 ms、119 ms,基线约 103 ms。
总结
世界建模在长时程和动态任务上价值更突出;二维语义表征是较稳妥的选择;MoT 的综合鲁棒性较强,Ext 更擅长少数据域内学习,Align 则适合重视部署成本的场景。
这些结论有适用边界:实验比较的是统一训练配置下的完整设计,并未匹配各方法的参数量与计算量;Qwen 与 π₀.₅ 也有多项架构差异,因此不能把兼容性差异完全归因于机器人预训练。
总结
本文围绕多种世界表征、四种具有代表性的集成范式,以及不同的策略骨干网络,对视觉—语言—动作策略中的世界建模开展了系统性的实证研究。
- 二维语义表征能够在不同范式下带来可靠的性能提升,而像素表征与三维表征对集成架构更加敏感。
- 不同集成范式具有各自的权衡:耦合式设计能够为静态操作提供紧凑的表征,而解耦式架构在分布偏移和动态操作条件下表现出更强的鲁棒性。
- 在适配预训练基础 VLA 时,解耦式集成展现出更好的兼容性。
我们希望,这一统一框架及其揭示的设计原则,能够为未来将世界建模融入机器人基础模型的研究提供有价值的指导。
局限性
为保证实证研究的严谨性,我们明确说明研究发现的适用范围、边界与局限性: (1)本文所讨论的 VLA 世界建模的范围 遵循具有代表性的 VLA 文献(Su et al., 2026; Zhang et al., 2025b; Zheng et al., 2025b; Chen et al., 2026b; Sun et al., 2026),我们将世界建模理解为以任务为条件、学习预测性前瞻能力的过程,重点是预测示范轨迹中的未来视觉表征,并将其作为动作生成的条件。 (2)不存在普遍最优的架构 尽管解耦式世界建模(例如 WM-MoT)通常在动态任务与长时程任务中表现出更强的鲁棒性,但耦合式方法在静态场景或某些域随机化设置下仍具有竞争力。例如,使用 Qwen 骨干网络时,WM-Align 在 RoboTwin Clean2Random 设置下略优于 WM-MoT,成功率分别为 14.8% 和 14.0%。 因此,最优架构的选择取决于任务时程、视觉分布变化以及示范数据量,而非由某一种范式始终占据优势。 (3)不同基础 VLA 策略之间存在混杂因素 基于 Qwen 的策略与 π₀.₅ 之间的实验差异,除了机器人专用预训练之外,还来自多项同时变化的设计选择,包括模型容量、视觉编码器和动作生成头。 因此,不应将性能差异完全归因于预训练经历;这些差异反映的是不同 VLA 骨干网络在整体系统层面的区别。 (4)表征选择涉及连续的权衡 尽管语义丰富的表征(DINOv3、SigLIP)具有最强的域外迁移表现,但生成式预测目标(例如 ImageVAE)仍能相较于仅预测动作的基线带来稳定提升。 对于表征的预测价值,更合理的理解是:它体现了语义抽象程度与细粒度空间信息保真度之间的权衡,而不是将像素空间与特征空间截然二分。