TacPAC:面向密集接触操作的世界-动作模型中的触觉预测与实时动作校正
TacPAC: Tactile Prediction and Real-Time Action Correction in World-Action Models for Contact-Rich Manipulation
一句话总结
TacPAC 让基座 WAM 先联合生成未来视触觉和动作块 (\hat{a}),使规划条件化于它预期会产生的接触;规划完成后在 (\tau=0) 再跑一次干净前向,把这份预期接触和规划本身缓存为逐层 KV。执行中每来一张触觉图 (I_m),触觉专家把它对照这份 cache 读取,输出 (\Delta a),只改尚未发出的后缀。单纯把触觉当额外视角去预测不够;必须在执行中把实际触觉和规划预期对齐,预测与校正才互补。
机器人先自己“脑补”一遍:接下来会看到什么、摸到什么,以及准备怎么动。这套动作不是瞎出的,而是按它以为即将发生的接触来规划的。 规划一旦定下来,就把这份“我以为会摸到什么、我打算怎么动”记在一份缓存里,后面不再重想整段计划。 真动手之后,每摸到一张新的触觉图,就拿来和缓存里“我以为会摸到的”对照。对得上就按原计划走;对不上,只改还没发出去的后面几步,已经做完的动作改不了。 所以:光提前预测触觉不够。必须边做边拿真实触感去对那份预期,预测和实时改动作这两件事得一起用。
摘要与引言
世界-动作模型(world-action models)利用预测的未来观测来引导动作生成,但以视觉为中心的预测会错过决定接触丰富操作成败的局部接触线索。提出 TacPAC,将触觉预测转化为实时动作校正。 一旦基座模型规划好一个动作块(action chunk),TacPAC 便将该规划所条件化的预测接触,连同规划自身的表征一并缓存;随后,一个触觉专家(tactile expert)将每一张新观测到的触觉图像对照该缓存进行读取,以校正尚未执行的动作
代码见 。
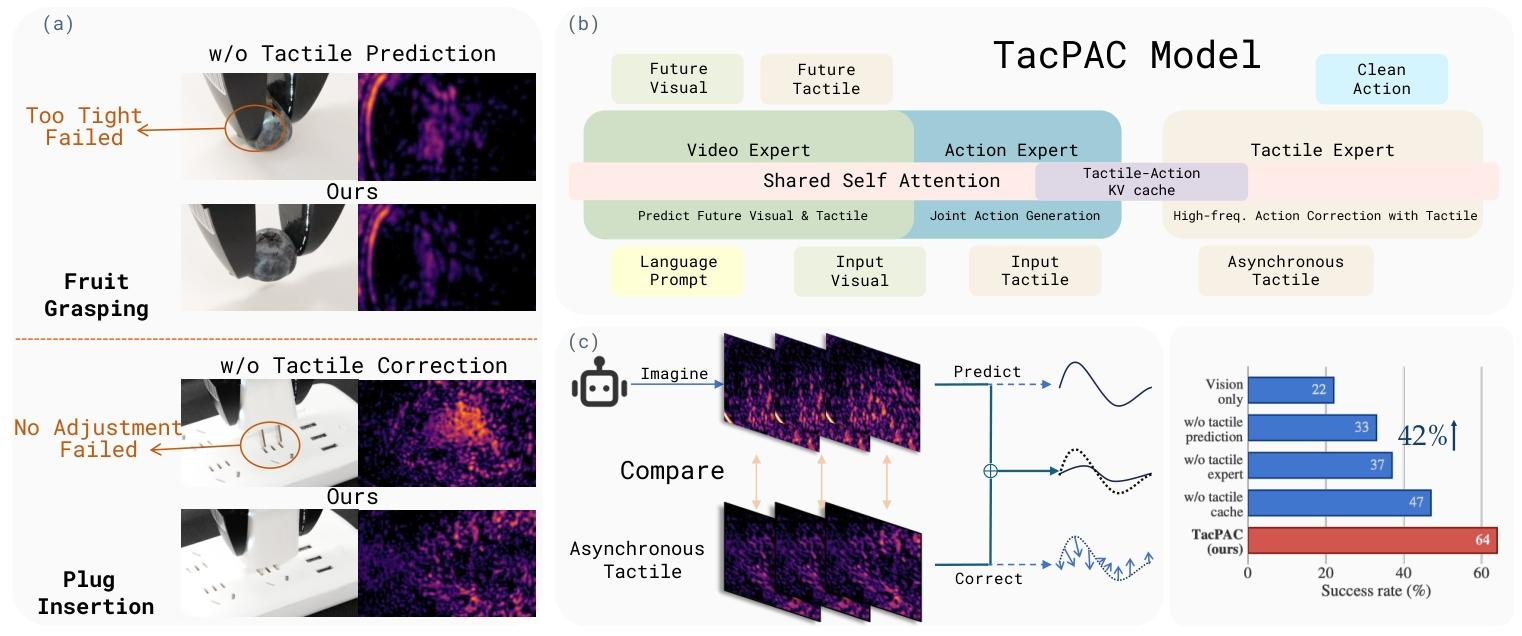 图 1:针对规划所预期接触的触觉校正。一旦模型知道它预期的是什么接触,触觉反馈就变得可操作。(a) 真实世界任务的消融实验,在推理过程中从传感器记录。(b) 基础模型联合生成未来观测和动作块,随后触觉专家根据当前触觉图像以及缓存的触觉和动作状态对该动作块进行校正。(c) 我们的关键见解:校正是将预测触觉与观测触觉进行比较,而不是仅与观测进行比较。(d) 每个组件消融的成功率,在五个真实机器人任务上取平均。
接触丰富操作要求机器人根据物理交互来调整动作,而不仅仅依赖可见的场景几何。触觉传感能够直接观测这些交互变化,并且已被证明对操作策略具有价值。 对于世界模型,当任务成功取决于在图像流中表现微弱或被遮挡的接触变化时,由此生成的动作仍然可能不可靠。 一种自然的补救办法,是让 WAM 同时预测触觉观测,将触觉图像视为与未来视频一并生成的额外视角。 原因之一可能是:有信息量的触觉变化在时间上是稀疏的,因此“未来视角”目标并不必然让动作生成对真正关键的接触转变变得敏感。更根本的是,执行前做出的预测无法修正那些已经规划、但尚未执行的动作。因此,关键挑战在于:如何把预测的触觉交互,与执行过程中实际获得的触觉证据连接起来。
提出 TacPAC,通过实时动作校正,使触觉预测真正可被执行所使用(图 1)。先规划一次,再拿“规划时预期的接触”当参照,用新到的触觉去改还没执行的动作。
具体而言:在基座模型中,视频专家预测未来的视觉与触觉观测,动作专家再通过 mixture-of-transformers 注意力(Liang et al. 2025)关注这些预测,从而使规划出的动作块条件化于它预期将产生的接触。一旦该动作块规划完成,TacPAC 便将这份完成的预测以及规划本身缓存为逐层注意力状态,并让一个触觉专家将每一张新观测到的触觉图像对照该缓存进行读取。因此,校正器看到的不仅是当前正在感知到什么,还包括规划当初假定会感知到什么,并针对尚未执行的步骤输出逐步的增量动作(delta action)。由于基座模型每个动作块只运行一次,而每次校正只是对固定缓存的单次前向,校正能够跟上触觉流,而不必等待下一次规划。
主要贡献如下:
- 指出触觉预测型 WAM 的一个实际局限:预测未来触觉观测能够提升任务成功率,但大部分可达收益仍未被实现,因为一旦动作块规划完成,该预测便被固定下来;
- 提出 TacPAC,将规划动作块所条件化的预测接触连同规划本身一并缓存,从而使当前触觉反馈对照规划所预期的接触来解释,而不是被孤立地使用;
- 设计一种单次前向的触觉校正器,在基座模型自身规划上、于密集采样的执行偏移处进行训练,并在五项接触丰富操作任务上评估最终系统。
方法
问题形式化
该策略以任务指令、当前视觉观测以及本体感觉状态为条件。在每个时间步 (t),触觉传感器还会额外提供其接触表面的原始图像 (I_t)。策略生成一个时域为 (H) 的动作块 (a={a_i}_{i=0}^{H-1}),并同时生成未来的视觉与触觉观测。
由于两种模态都以图像形式到达,我们将它们拼贴为同一条视频流,并编码为单一潜变量 (z):每个触觉传感器作为与相机并列的额外视角进入,因此预测未来触觉观测本身就是预测未来视频的一部分。
观测生成与动作生成均采用条件流匹配(conditional flow matching)。对于干净样本 (x) 和高斯噪声 (\epsilon),我们构造
其目标速度为 (u=\epsilon-x)。观测到的第一帧保持干净,而未来观测潜变量与动作块则从噪声出发。流时间 (\tau) 只索引这条生成路径,与观测到达时的物理时间 (t) 无关。
TacPAC 建立在一个可预测触觉的世界-动作模型之上:视频专家与动作专家被组织为 Mixture-of-Transformers(MoT),分别预测加噪视频潜变量 (z_\tau) 与动作块 (a_\tau) 的速度,并通过对拼接 token 序列的逐层注意力进行交互。 使用非对称掩码,动作可见视觉、触觉,视觉、触觉不可见动作。 由于该视频流包含触觉视角,触觉 token 同时扮演两种角色:既是模型所生成内容的一部分;又是动作块被生成时所依据内容的一部分。 于是,动作块被条件化于模型预测其自身动作将会产生的接触。我们称该模型为基座模型。它对干净动作块的估计记为 (\hat{a}),即规划动作块:在任何执行反馈到来之前就已经提交的动作。
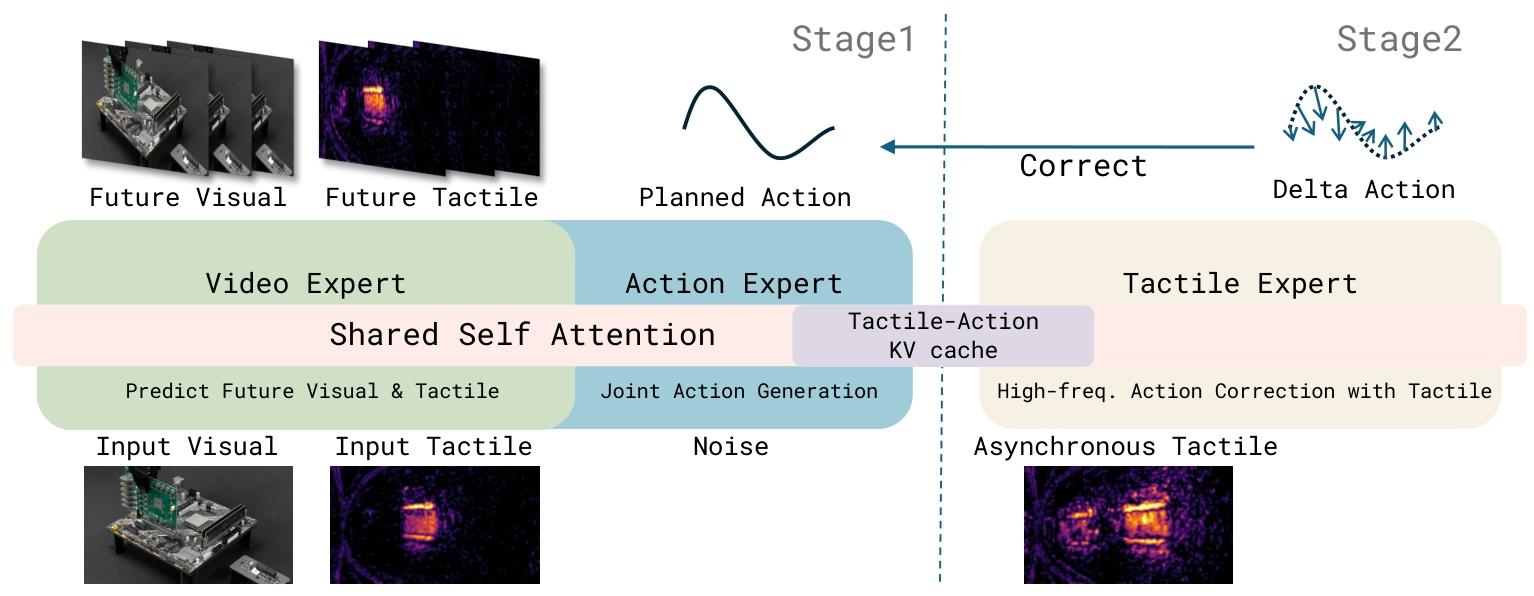 图 2:TacPAC 概述。我们的方法采用三专家混合 Transformer(Mixture-of-Transformers)架构:视频专家预测未来的视觉和触觉观测,动作专家以这些预测为条件生成规划动作块 (\hat{a}),触觉专家则根据缓存的触觉–动作 KV 和当前触觉观测输出一个增量动作 (\Delta a),用以校正 (\hat{a})。由于缓存被复用,这种校正以触觉帧率异步运行,而无需重新运行另外两个专家。阶段 1 训练视频专家和动作专家。阶段 2 冻结它们,仅训练触觉专家。
一旦动作块规划完成,这种条件化便被固定下来:预期接触是执行前做出的假设,当实际发生的接触偏离该假设时,没有任何机制去修正规划。TacPAC 正是为此增加了一条校正路径(图 2)
以预测为基准的触觉校正
动机
要从触觉反馈校正一个动作块,不仅需要知道当前正在感知到什么,还需要知道本应感知到什么。
动作块是与预测的未来触觉流联合去噪的,并且在每一层都关注该流,因此预测中的误差会传播为动作块中的相关误差。于是,我们将这份预测连同动作块自身的内部表征一并交给校正器,使新的触觉图像对照该动作块所预期的接触来读取。
缓存预测与规划
基座模型去噪完成后,在流时间 (\tau=0) 再额外跑一次前向,用干净预测生成缓存;不复用最后一步去噪的 KV,避免缓存里带噪声。
缓存 (C) 只存两类内容:
- 触觉视角:编码模型预测的接触;
- 动作 token:编码规划动作块在关注该触觉预测时的内部表示。
- 不存视觉 key:校正要处理的是动作步内快速变化的接触,而场景在一个动作块内几乎不变,且已隐含在上述两类缓存中。
- 每个动作块只构建一次缓存;之后每次触觉校正只读不改,异步复用。
触觉专家
触觉专家是一个单次前向的校正器。
- 触发时机:一个动作块已执行 (m) 步后,收到当前触觉图像 (I_m) 时。
- Query 组成:
- 当前触觉图像 (I_m);
- 规划动作块 (\hat{a}) 的更新版本。
- 触觉图像编码:复用生成缓存触觉 key 时同一套冻结视频 tokenizer + 触觉 patch 嵌入,进入同一嵌入空间。
- 动作块更新:
- 前 (m) 项 → 替换为实际发送给机器人的指令;
- 剩余项 → 保留基座模型的规划值;
- 每项附加一个可学习状态嵌入,表示该动作是否已执行。
- 注意力:每一层 query 联合关注:
- 缓存 (C);
- 触觉专家自身的 token。
- 输出:逐步增量动作 (\Delta a),用于校正规划动作块。
- 特点:单次前向、异步运行、只读缓存,不重跑视频/动作专家。
每一层都将这些 query 联合关注到 (C) 以及该专家自身的 token。专家输出逐步的增量动作
再将其加到 (\hat{a}) 上,得到校正后的动作块 (\hat{a}+\Delta a)。
该专家与基座专家共享深度与注意力几何,从而能够消费它们的逐层缓存。
任务指令不直接喂给触觉专家 触觉专家本身不读语言 prompt。语言只在基座模型规划动作块时起作用,并被写进缓存里的 key。触觉专家后来只读这些 key,所以它是间接知道“现在在干什么任务”。
触觉专家用的是执行进度 (m),不是流匹配里的噪声时间 (\tau) (\tau) 是生成时的噪声程度;(m) 是这个动作块已经执行了几步。 新到的触觉图按 (m) 对齐到规划的某一阶段,于是校正器知道:
- 该对照缓存里哪一段预期接触来读这张图
- 动作块里后面还有多少步还能改(前 (m) 步已经发出,不能动)
技术优势
用缓存做校正,又快又稳。
- 快: 每次校正只跑一次触觉专家,读固定缓存,不重跑视频专家、也不重新去噪。否则每来一帧触觉都几乎等于重新规划一次,跟不上触觉帧率。
- 稳: 每次都是在原始规划动作块上加新的 (\Delta a),不是叠在上一次校正结果上。前面已发出的动作会作为前缀读进去,但后面的旧校正会被新校正替换掉,所以一次改错不会一路传下去。
训练与推理
阶段 1:基座模型
我们首先在完整流区间上训练视频专家与动作专家:以第一帧视觉–触觉作为观测条件,并对独立加噪的未来潜变量与动作由 MoT 联合处理。目标函数是视频流匹配损失与动作流匹配损失的加权和:视频项同时覆盖未来视觉潜变量与未来触觉潜变量;动作项则在把预测速度转换为干净动作估计之后,在动作空间中施加。阶段 1 得到一个不含触觉专家、用于规划动作块的基座模型。
阶段 2:触觉专家
阶段 2 冻结阶段 1 中训练的全部内容,只优化触觉专家。由已训练的动作专家初始化,从而从一个已经知道如何读取基座模型逐层状态的模块出发
每一次更新都复现部署路径(算法 1,训练):冻结的基座模型按测试时使用的去噪日程规划一个动作块,再按第 3.2 节的预填充(prefill)从该动作块构建 (C)。在模型自身的规划上、而不是在真值动作块上训练,正是为了保持两条路径一致——因为专家必须校正的量,恰恰是基座模型所规划内容与任务所需内容之间的差距。
数据加载器为每个训练 episode 提供若干执行偏移,每个偏移配对该偏移处记录的触觉图像。对于偏移 (m),已执行前缀填入真值动作——即产生该触觉图像的那些指令——而剩余步骤保留其规划值;专家只在仍可施加校正的位置上被监督:
因此,增量动作被监督为:在该执行时刻可用的触觉证据条件下,规划动作块与真值动作在未执行后缀上的残差。在整个时域上密集采样偏移,使专家接触到每一个执行阶段
算法 1 触觉专家的训练与推理
训练——更新触觉专家,基座模型冻结
输入: 带触觉图像 ({I_t}) 的真值动作块 (a),时域 (H),每个动作块的偏移数 (K)
- 用冻结的基座模型规划 (\hat{a}),并预填充 (C);
- 对 (k=1,\ldots,K) 重复:
- 采样偏移 (m\sim\mathrm{Unif}{0,\ldots,H-1});
- 将 (\hat{a}) 的前 (m) 项用真值覆盖;
- 计算 [ \Delta a \leftarrow f(I_m,\hat{a},m,C), ] 并对 (i\ge m) 累加损失(目标是 (\hat{a}_i+\Delta a_i) 靠近真值 (a_i))(3);
- 循环结束。
推理——一个动作块
- 基座模型完成去噪并返回 (\hat{a})(机器人执行从此处开始);
- 由去噪后的视频潜变量与 (\hat{a}) 预填充 (C);
- 当该动作块尚未耗尽时重复:
- 一帧触觉在偏移 (m) 到达,计算 [ \Delta a \leftarrow f(I_m,\hat{a},m,C); ]
- 对 (i\ge m+d) 提交 [ \hat{a}_i+\Delta a_i. ]
推理
一个动作块按三步提供服务(算法 1,推理) 基座模型一旦生成动作块,机器人便立即开始执行。随后,预填充在前几个动作已经在途中时完成计算。此后每到达一帧触觉,就对当前活动动作块触发一次校正;只有当该时域耗尽时,基座模型才会再次运行。
由于机械臂在校正计算期间仍在运动,校正无法施加在它所条件化的那个偏移上:等它返回时,那些指令已经发出。因此,每次校正仍在其触觉帧被采集的偏移 (m) 处进行条件化——这正是专家训练时所配对的关系——但只从 (m+d) 起写回,其中 (d) 是最近短窗口内观测到的最大校正延迟,以动作步计
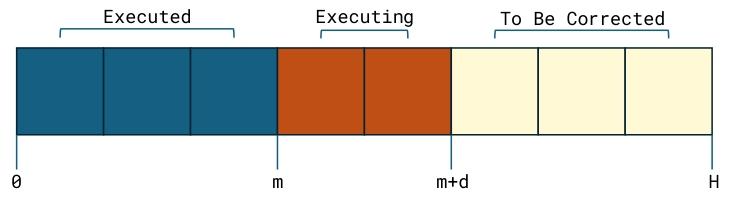 图 3:触觉专家的异步推理。在动作块偏移 (m) 处的一帧触觉会触发一个增量动作 (\Delta a),该增量动作在 (d) 步之后到达:(m) 之前的步(蓝色)已经执行完毕;([m, m+d)) 中的步(橙色)在 (\Delta a) 计算期间运行;只有从 (m+d) 到 (H) 的步(黄色)才会应用它。
该窗口内的步骤保留最近一次为它们提交的值,已经执行的动作不可更改(图 3)。实践中这个窗口几乎为空
实验
实验设置
真机:Flexiv Rizon 4,夹爪两枚 InTac S1;腕部 D405 + 第三人称 D435i。 输入:指令 + 双相机 + 本体感觉 + 双触觉。视觉-only 方法不补触觉。 动作:7 维相对关节 + 1 维夹爪,30 Hz;chunk H=48(约 1.6 s),执行完才规划下一块。 校正发生在当前 chunk 内部,异步写未执行后缀。 训练:8×H100,batch 64,10 epoch;Stage 2 只训触觉专家。TacPAC 没有预训练。 五项任务都是接触决定成败:插头插入、三水果转移、薯片转移、空瓶扶正、扩展卡插入。水果/薯片损坏即失败。 基线覆盖四类:VLA(π0.5)、模仿(ACT)、反应式视觉-触觉(VITaL)、视觉 WAM(LingBot-VA),以及两个最近的触觉 WAM(Dream-Tac 有预测无执行中修正;T-Rex 有实时修正但没有预期接触可对照)。 每方法每任务 20 次真机,失败全计,不因结果剔除。
实验设计
Q1 总体能力:5 任务 × 7 方法。 Q2 为何只预测不够:接触转变只占 4.9% 帧,却贡献 18.6% 触觉变化,而且发生在 chunk 已经开始执行之后。 Q3 组件是否必要:逐条切断预测 / 校正 / cache 访问。 Q4 能否实时:测单次校正延迟,并看校正期间机器人有没有已经走出一步。
实验效果
| 方法 | Plug | Fruit | Chip | Bottle | Card | 平均 |
|---|---|---|---|---|---|---|
| π0.5 | 60 | 50 | 70 | 0 | 0 | 36 |
| ACT | 0 | 0 | 0 | 0 | 0 | 0 |
| VITaL | 30 | 20 | 55 | 5 | 0 | 22 |
| LingBot-VA | 10 | 40 | 70 | 20 | 0 | 28 |
| Dream-Tac | 55 | 40 | 85 | 25 | 20 | 45 |
| T-Rex | 65 | 35 | 75 | 30 | 35 | 48 |
| TacPAC | 80 | 65 | 90 | 40 | 45 | 64 |
消融最关键的三行:
- 只预测:22% → 37%,大约只拿到完整收益的 1/3
- 只做反应式校正:33%;损坏任务上甚至低于纯视觉(薯片 45 vs 60,水果 25 vs 30)
- 有预测也有校正,但不让校正器看 cache:47%;打开 cache 访问后到 64%(+17)
实时性:一次校正 30.4 ms(32.9 Hz),比重新生成 chunk 便宜 20.7×;只有 1.6% 的校正调用期间机器人走出了 ≥1 步,观测不到校正引起的抖动。
总结
不是“有触觉输入就行”。VITaL 和视觉 WAM 都打不过 π0.5;必须把触觉放进世界-动作建模。 Dream-Tac 赢损坏类、输插入;T-Rex 相反。缺口正好对应:一个不能在执行中改计划,一个没有“预期接触”可对照。 方法核心被实验钉死:切断 cache 访问就掉 17 个点。当前触觉要对照规划预期来读,而不是孤立使用。 一句话:WAM 先想象接触并据此规划;TacPAC 在执行中把实际触觉拿来和这份想象对照,只改还没发出的动作。
总结
提出 TacPAC,一种面向接触丰富操作的触觉世界-动作模型,将触觉预测转化为执行过程中的实时校正。 一个触觉专家将每一张新的触觉图像对照逐层触觉缓存进行读取,并异步校正已规划的动作块。 总体而言,我们的结果表明:触觉预测与触觉校正是互补的,而将接触反馈对照一份显式预期来读取,是实现闭环接触丰富操作的一条可行路径。
局限性
方法边界
- 改的是未执行后缀,不是世界模型。Stage 2 冻结视频/动作专家,规划错得很深时,只能在当前 1.6 s chunk 里打补丁。
- Cache 不存视觉 key,默认一个 chunk 内场景几乎不变。物体被碰飞、滑出视野时,校正器未必读得到。
- Delta 总是加在原始 (\hat{a}) 上,不在上一次校正上递进,因此做不了多步接触推理。
- 没有显式“预测触觉 vs 观测触觉”,差异全靠注意力隐式学,可解释性和可迁移性都弱。
- 触觉专家不直接看语言指令;训练时用真值前缀,测试时用实际发出的指令,存在分布偏移。
- 仍是 30 Hz 位置 chunk,不是力/阻抗闭环。32.9 Hz 对策略层很快,但远低于经典触觉伺服。
实验范围
- 单一本体、平行夹爪、两枚 InTac S1;无跨机器人、无灵巧手、无预训练规模化。
- 5 任务 × 20 trial,只有二值成功,几乎没有 held-out 泛化。
- 最难任务仍未解决:空瓶 40%、扩展卡 45%。领先不等于可用。
- ACT 全 0 过弱,部分对比的说服力会被稀释。
问题是被绕开,不是被修好
- Q2 已经说明未来视角损失会被静止触觉帧主导。TacPAC 没有改预测目标,只是另开一条执行中校正。
- 接触预测质量本身(接触时刻、滑移、形变)没有单独报告。如果预期本身系统性偏差,校正对照的参考就是错的。
一句话判断 贡献是把触觉预测从“生成时的条件”变成“执行时的参照”。局限是:它仍是 chunk 级、单臂、传感器绑定的残差校正,还不是通用接触闭环,也没有证明世界模型真正学会了接触物理。