World Models Dream of Success_ Diagnosing and Repairing Failure Insensitivity in Robot World Models
World Models Dream of Success_ Diagnosing and Repairing Failure Insensitivity in Robot World Models
一句话总结
CureWM 是一种针对已发布机器人世界模型的后训练方法。它以成功示范为基础,从相同初始情境出发,保留干预前的动作,并按离散的强度网格构造不同程度的动作扰动;随后在仿真或实机中执行,验证真实结果,同时保留成功与失败的重放轨迹。最后,将这些轨迹与原有训练数据混合,在不改变模型架构和训练目标的情况下进行微调,以提升模型区分成功与失败动作后果的能力。
摘要
机器人世界模型可用于策略评估、规划和合成数据生成,但这些应用要求模型的预测能够区分成功动作与失败动作。
目前的机器人架构对动作变化的敏感性较弱,而且对于已经验证会失败的动作,仍会给出类似成功的预测。 尽管近期研究已将失败样本纳入模型训练,但在不改变模型架构或训练目标的前提下,哪些数据能够修复已发布的模型检查点,仍缺乏充分研究。
提出了 CureWM 以成功示范为基础,按照一组离散的扰动强度构造替代动作,通过在仿真或实体硬件上执行来验证其结果,再将由此得到的失败轨迹、扰动后仍然成功的轨迹,以及原始示范共同用于微调已发布模型。这种构造方式能够在相同的初始情境下,提供受控的动作对照。
引言
模型必须能够区分哪些动作可以完成任务,哪些动作会失败。 如果模型为失败动作赋予较高的成功价值,或生成类似成功的未来场景,那么基于这些预测作出的决策,就可能偏向那些无法实现预期结果的动作。
如何修复已发布机器人世界模型的失败预测能力,仍缺乏充分研究。 问题在于:哪一类数据能够对以动作为条件的预测进行事后修复,以及如何区分这种修复与模型整体上变得更加悲观这两种情况。 如何在保留架构与训练目标的情况下修复已发布的模型检查点,以及在这些约束下,哪类失败数据最有效?
为填补这些研究空白,我们提出了 CureWM。其出发点是这样一个观察:能够正确预测已观察动作的结果,并不意味着模型知道,在同一情境下换用另一动作会如何改变结果。 CureWM 按照一组离散的扰动强度对成功示范施加扰动,同时保留干预发生之前的动作;随后通过执行来验证结果,并保留失败和成功的重放轨迹,用于后训练。模型架构和训练目标均保持不变。
我们的贡献如下:
- 我们提出了 CureWM,利用经过执行验证的反事实重放来修复已发布的世界模型,无须改变其架构或训练目标。
- 我们在仿真环境和实体机器人上验证了修复效果,包括成功与失败区分能力以及失败检测能力的提升。在 LIBERO 上条件匹配的对照实验中,相较于使用新采集的策略失败样本进行训练,我们的方法表现出更强的区分能力。
- 我们表明,仅根据乐观偏差的降低来判断,可能会高估修复效果;因此,我们将成功与失败的区分能力,以及对成功动作的误报情况结合起来进行评估。
方法
AUROC 综合考察不同阈值下的表现。直观上,它衡量的是:随机抽一个失败样本和一个成功样本,模型有多大概率给失败样本更高的失败分数;分数相同时按半次正确计算。(scikit-learn.org)
- 1.0:成功与失败可以被完全正确地排序。
- 0.5:排序区分能力相当于随机水平。
- 低于 0.5:排序倾向于反向,需要检查分数方向或模型表现。(scikit-learn.org)
| 论文中的指标 | 通俗含义 | 期望方向 |
|---|---|---|
| 价值乐观偏差 Value optimism | 实际失败的动作中,有多少仍被赋予高于阈值的成功价值? | 越低越好 |
| 视觉乐观偏差 Visual optimism | 实际失败的动作中,有多少预测画面仍更接近成功参考结果? | 越低越好 |
| 成功—失败差距 | 从同一起点出发,成功动作的得分比失败动作高多少? | 更大的正差距表示更强的平均区分 |
| 配对排序准确率 | 同一起点的成功、失败动作对中,有多少对被正确排序? | 越高越好 |
乐观偏差下降了吗?——失败还会不会被当成成功? AUROC、 提升了吗?——模型是否更能区分两者? 误报率升高了吗?——有没有把原本能成功的动作也大量判成失败?
对失败的不敏感性
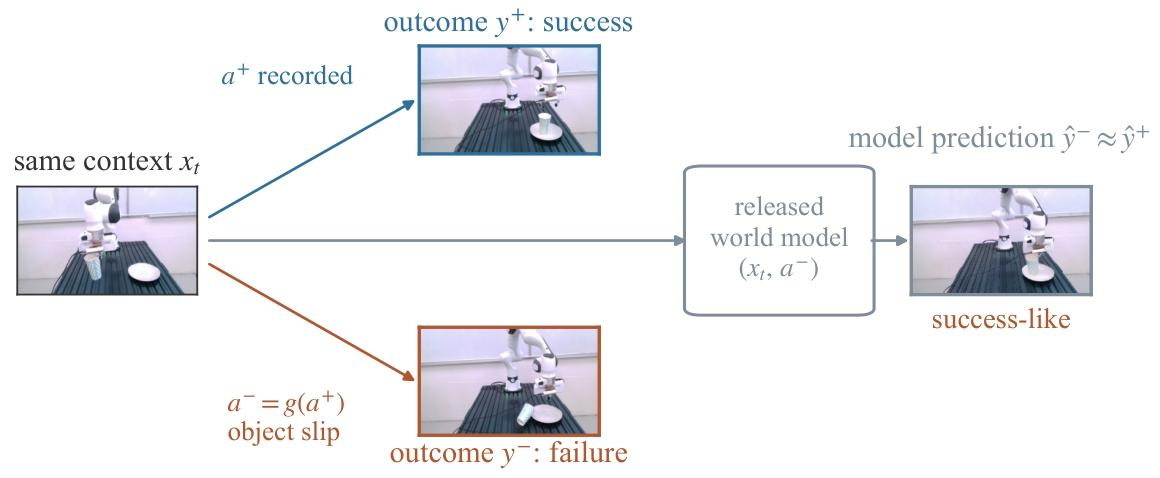 图1:在留出的Franka反事实样本上的失败不敏感性。从相同的起始上下文出发,原始动作序列在物理执行中成功,而扰动后的序列失败,然而模型却对失败的序列预测出类似成功的未来。
令 表示观测历史与任务情境,令 和 分别表示从相同初始情境出发、能够成功和会导致失败的动作序列。当模型的预测无法区分这两种结果时,我们称该模型具有失败不敏感性(failure insensitivity)图 1 展示了这一现象。
这与单纯的乐观偏差有所不同:即使模型给出的两个价值都不高,它仍然可能为成功动作和失败动作赋予相近的价值。因此,我们既评估模型对失败动作的预测,也评估其区分成功动作与失败动作的能力。
衡量对失败的敏感性
价值预测
对于能够通过自身的价值预测机制输出 的模型,我们在 对动作上计算平均成功—失败价值差距:
正的价值差距意味着,平均而言,成功动作获得的价值高于失败动作。我们同时报告这两类动作的价值,以检查区分能力的改善是否以低估成功动作为代价。
将 0.5 用作模型自身价值预测的固定诊断阈值,但并不假设该价值是经过校准的成功概率。误报率衡量的是:按照这一阈值,被标记为失败的成功重放轨迹所占的比例。
我们将价值乐观偏差(value optimism)定义为:在经过验证的失败序列中,满足 的序列所占的比例。在 LIBERO 上,我们采用 。将扰动后仍然成功的重放轨迹也纳入评估后,我们还报告 AUROC,即受试者工作特征曲线下面积(Fawcett, 2006),以及被错误预测为失败的成功重放轨迹比例。
视频预测
令 表示预测图像的表征,令 和 分别表示对应动作对在实际执行中记录下来的成功结果与失败结果。利用冻结的编码器 ,我们定义:
其中, 是图像表征之间的均方距离,并在模型使用的各个相机视角上取平均。正分数表示预测结果更接近成功参考结果。 我们报告以下指标:
视觉乐观偏差:失败序列中满足 的比例。
失败动作的平均得分。
平均配对差值
配对排序准确率:满足 的动作对所占的比例。
这些指标均属于离线诊断,需要使用记录下来的参考结果。
CureWM
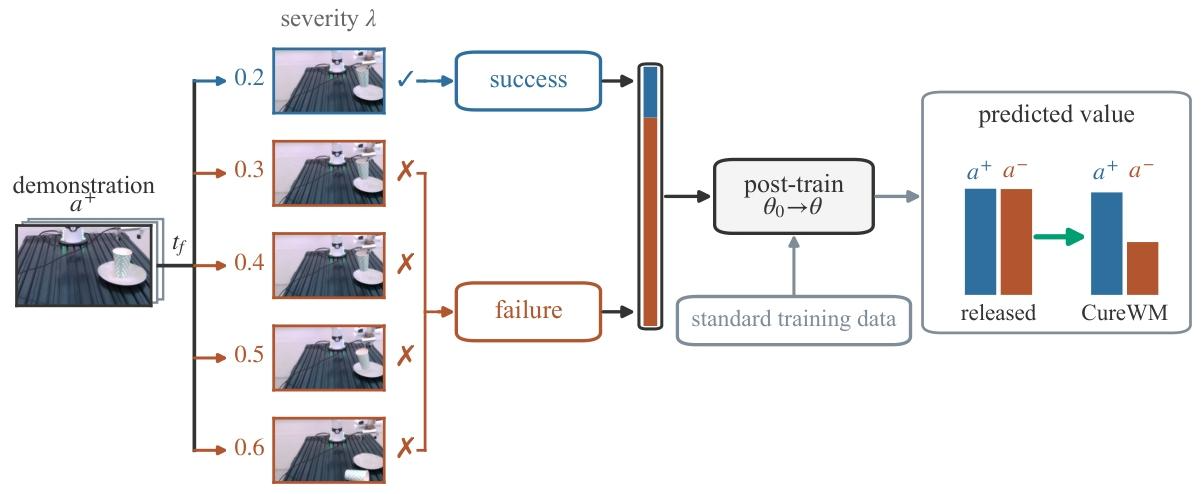 图2:CureWM概览。我们以不同严重程度扰动成功示范,通过执行验证结果,并将成功和失败的回放与原始训练数据一起用于后训练。严重程度值、结果分配和预测值条仅用于示意,而非实测结果。
CureWM 为后训练构造经过执行验证的替代动作方案,如图 2 所示。其出发点是这样一个观察:当每种情境下只观察到一个动作时,模型即使拟合了该动作的结果,也不必学会区分其他动作会带来的后果。
受控的反事实构造
将一条成功示范表示为:
其中, 是初始情境, 表示任务是否成功。 我们识别接近、抓取、搬运和放置这几个阶段,并针对扰动类型 选择干预时刻 。遵循 MiraBench ,我们在适用的情况下采用以下扰动类型:接近过冲、搬运时滑落、接触振荡、夹持力度不足、过早释放,以及腕部倾斜。 对于扰动强度 ,我们构造:
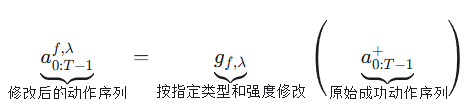
扰动强度网格 能够生成多个替代动作序列,同时保留干预之前的动作。在执行之前,我们不会将这些替代序列标记为失败。
基于执行的结果验证
在仿真或实体硬件上,从相应的初始情境出发执行每一个修改后的序列,并记录其观测、实际执行的动作,以及任务结果 。 只有当某一扰动类型在相邻且递增的扰动强度下,其经验失败率满足下式时,该类型才会被纳入训练:
这一条件作用于汇总后的失败率,而非要求每条示范都单独满足该条件。(作者要求,一类扰动总体上应该满足“扰动越强,失败率越高或保持不变”,才把这类扰动产生的数据用于训练。)
我们将成功和失败的重放轨迹分别保留为 和 。对于单个扰动类型,在测试的扰动强度范围内,并不要求它同时产生成功和失败两种结果。
使用经过验证的轨迹进行后训练
我们使用转换操作 ,将重放轨迹转换为已发布模型所采用的训练格式,再将其与模型的基础训练数据合并:
其中, 包含相应模型所使用的示范和官方执行轨迹, 表示合并数据而不删除重复项。
对于带有价值头的模型,失败重放轨迹的价值目标设为零。成功重放轨迹则沿用原始的标签赋值规则,即根据剩余步数对最终成功奖励进行折扣。 对于视频预测,监督信号来自执行过程中记录的观测。 从已发布的参数 出发,我们使用模型原有的目标函数,对整个预测网络进行微调:
其中, 是一个训练样本, 表示在 上沿用模型现有采样流程得到的采样分布。 成功轨迹与失败轨迹通过其构造过程相互关联,但训练时并不会将它们作为显式配对的样本提供给模型。我们既不引入新的预测头,也不引入成对损失函数。
实验
目的
实验主要回答三个问题:
- 在不修改架构和训练目标的情况下,CureWM 能否让已发布的世界模型更好地区分成功与失败?
- 改进是否来自经过执行验证的反事实数据构造,以及保留扰动后仍成功的轨迹?
- 预测能力的改善能否迁移到其他任务,并进一步改善机器人控制?
实验设置与评价方式
- 模型与环境:在 Cosmos Policy 和 Ctrl-World 两类模型上验证;仿真使用 LIBERO、RoboCasa,实体实验使用 Franka Research 3,主要任务为杯子抓取放置,另用方块抓取测试迁移。
- 基本对照:比较原始发布模型、继续使用官方数据或成功示范微调的基线,以及加入反事实重放的 CureWM。主要对照匹配训练步数,以检查改善是否只是来自额外训练。
- 数据构造:从成功示范出发,在不同强度下扰动动作,实际执行后确认成败,同时保留失败与成功的重放轨迹。
- 评价指标:同时观察乐观偏差、成功—失败区分能力、成功动作误报率和实际任务成功率。这样设计是为了排除一种情况:模型只是把所有动作都预测得更悲观,却没有真正理解动作后果。
主要实验
| 实验 | 设计及原因 | 结果与结论 |
|---|---|---|
| LIBERO:主要有效性与跨任务迁移 | 使用四个任务套件的官方数据训练,但只额外加入 Goal 套件的反事实重放;既检查直接修复效果,也检查向其他套件的迁移。 | Goal 上乐观偏差约从 80% 降至 30%,AUROC 从 0.495 升至 0.743;Spatial、Object 也改善,LIBERO-10 基本无改善。说明修复有效,但迁移不均衡;部分成功动作的误报率反而上升。 |
| RoboCasa:预测改善是否带来控制改善 | 比较只覆盖抓取的重放、加入抽屉和门任务的重放,以及屏蔽失败轨迹动作预测损失的设置;分别评估失败检测、动作敏感性和实际任务成功率。 | 扩大数据覆盖后,失败检测 AUROC 可从 0.634 升至 0.839。但动作敏感性提升最大的设置,任务成功率下降明显。说明预测敏感性、失败检测和控制性能不会同步改善。 |
| Ctrl-World:视频预测模型上的有效性 | 与仅使用成功示范微调的模型比较,检查失败动作生成的视频是否更接近真实失败结果,以验证方法能否用于视频预测。 | 留出的 10 对动作中,视觉乐观偏差从 8/10 降至 6/10,失败动作得分也下降;但乐观偏差比例的差异未得到统计确认。结果提供初步支持,证据相对有限。 |
| 实体机器人:物理环境中的修复 | 对杯子抓取放置构造并实际执行扰动;在留出的示范上进行两次评估,并加入盲评,检查自动距离指标是否符合人类观察。 | 两次评估合计,视觉乐观偏差从 27/30 降至 10/30,失败检测 AUROC 从 0.67 升至 0.90。人工评价支持改善方向,但与距离指标的绝对判断不同。方块任务支持针对性修复,杯子到方块的迁移未得到确立。 |
数据设计与消融实验
| 要验证的问题 | 实验设计与结果 | 能说明什么 |
|---|---|---|
| 是否随便加入失败数据就有效? | 匹配每个任务的失败样本数、成功重放数据和训练步数,比较新采集的策略失败与反事实失败。成功—失败价值差距分别为 0.014 和 0.124,反事实失败更好。 | 在该预算和评测下,失败数据的构造方式很重要。但两组数据的失败类型、时机和覆盖也不同,不能将优势完全归因于共享动作前缀。 |
| 扰动后仍成功的轨迹是否有用? | 删除这些轨迹,或替换成其他示范生成的成功重放,整体效果均弱于完整 CureWM。实体实验中,仅增加成功重放也不能复现完整改善。 | 支持同时保留成功和失败的扰动结果;但训练波动与数据组成差异,使“必须来自同一示范”的因果结论仍不充分。 |
| 为什么必须执行验证? | 将所有扰动轨迹都标为失败,包括实际上成功的轨迹。模型会变得更悲观,但成功动作的价值也被大幅压低,区分能力弱于完整方法。 | 扰动不等于失败,真实结果标签很重要;乐观偏差下降本身不能证明修复成功。 |
实验结论与局限
CureWM 的主要证据是:经过执行验证的反事实重放,能够改善已发布世界模型对成功与失败的区分;在本文的匹配对照下,比直接加入新采集的策略失败更有效。
但实验尚未证明稳定的跨任务泛化或控制收益。部分任务仍然失效,成功动作可能被更多地误判为失败;LIBERO 测试示范大多存在于共享官方数据中,实体实验规模也较小。因此,更适合将本文理解为对预测可靠性修复的验证,而非机器人整体能力提升的证明。
总结
提出了 CureWM,通过经过执行验证的反事实重放,在不改变架构或训练目标的情况下,修复已发布的机器人世界模型。仿真与实体实验表明,该方法能够改善模型区分成功与失败的能力。
在所测试的训练预算下,条件匹配的对照实验表明,反事实失败样本的效果优于新采集的策略失败样本;消融实验则支持保留来自同一示范的成功重放轨迹。
这些结果还说明,乐观偏差降低本身并不足以证明修复成功。更广泛的迁移能力,以及机器人控制性能的改善,仍是有待解决的挑战。
局限性
在 LIBERO-Goal 的 484 个失败样本中,只有 53 个来自未出现在共享官方数据中的示范。方法在不同扰动类型和不同物体之间的迁移效果并不一致,而且预测时域限制了模型能够观察到的失败后果。对 Cosmos Policy 视频预测的修复也仍不充分。
实体实验的证据仅覆盖一台机器人上的两种物体,留出测试样本较少,且不同训练设置的数据量并不相等。CureWM 要求反事实动作能够被实际执行,其结果也必须可以验证;实体机器人上的失败检测还需要针对各次任务执行单独记录的参考结果。
预测能力的提升并不能证明控制性能得到改善:RoboCasa 实验呈现出预测修复与控制性能之间的权衡;从 个候选中选择最优方案(best-of-)的实验未显示出统计上得到确认的收益;方法用于策略排序的效果也尚未测试。